来源:Bilibili《别再用 AI 瞎炒股了!GDE 专家拆解真实量化智能体:从避开未来函数到全自动回测 - 黄鸿波 #devfest#》 视频地址:https://www.bilibili.com/video/BV1gBWX6hEHp/ · UP 主:GDGXian · 发布:2026-11-12 时长:61 分 36 秒(3696 秒,单 P) · 本报告处理方式:无官方字幕,下载 720p 视频+音频,用 faster-whisper
large-v3(CUDA / float16)本地全量转写,再做事件驱动的画面取帧与全文整理 覆盖:00:00—01:01:35 全程按上传者给出的 15 个章节推进,实质性内容基本全覆盖
一、来源与处理说明
本报告是对一场线下开发者分享(DEV FEST 2026 · GDG Xi'an[1])的完整内容整理。原始视频没有平台字幕(Bilibili 播放器接口 subtitle.subtitles 为空数组),因此采用本地语音识别获得时间轴后,再按章节重建叙述。视频为单机位拍摄的现场演讲+投屏,画面中约三分之二是可读的幻灯片,其余是产品实操录屏与现场问答。所有关键帧均取自讲者明确指示观看的画面或演示状态切换处,见文末《关键帧索引》。
三点阅读提醒:
- 这是一位创业者对自己产品的分享,涉及收益、胜率、回测数据的表述均为讲者自述,报告如实转述但不做背书;
- 现场录音有大量口语重复与自我修正,报告做了轻度整理(合并同一段的重复起句、补全省略的主语),但保留了讲者的判断、犹豫和限定条件;
- 语音识别对专有名词有系统性误听(例如把 Gemini 听成"金蛋/静爱/DVD"、Claude 听成"Cloud/Cless"、QMT 听成"KMT"、AKShare 听成"AKCR"、Codex 听成"Protect/扣带死"),报告中已按上下文校正,存疑处在《局限与转写不确定性》中集中列出。
二、阅读导引
整场演讲其实只回答一个问题:当大模型已经能写代码,普通人用 AI 做量化,卡点到底在哪?
讲者的答案分四层,也正好构成本报告的主线:
- 第一层(01:09—12:20):先把"量化"从玄学拉回工程。量化的定义是"明确规则 + 数据计算 + 历史验证",它的反面不是"不赚钱",而是两种具体错误——把量化当成预测,以及回测时踩到"未来函数"。
- 第二层(12:20—22:15):为什么需要大模型。不是因为模型能预测涨跌,而是因为它能把"我偏好趋势跟随,上涨后继续持有"这种模糊表述逼问成可执行的买入、退出、计算时点与风控参数。讲者给出的技术分工是:Gemini 负责理解与生成,Claude 负责写代码,平台 Runtime 负责取数与计算。
- 第三层(22:15—46:00):落到产品形态。一个 AI 工作区如何用四类上下文(任务会话、工作目录、Skills 规范、工具与事件)组织任务,一个"回测师"如何按"先冻结数据、再运行代码"的顺序执行并被审计,以及这些能力如何变成每天盘前自动推送到微信的策略。
- 第四层(46:00—01:01:35):六个现场提问,集中在实盘接口(QMT)、法律合规、真实胜率、商业护城河、指数基金支持与舆情去伪存真——这一段的坦白程度高于前面的产品介绍,值得单独阅读。
如果只读一段,建议读第七章(Gemini 六大特性与"模型不替代计算与授权"的分工)和第八章(AI 工作区的四类上下文与回测执行链),这两处是整场分享里最能直接复用的设计经验。
三、全文叙事
00:00—01:09 开场:先看成绩单,再讲要解决的问题
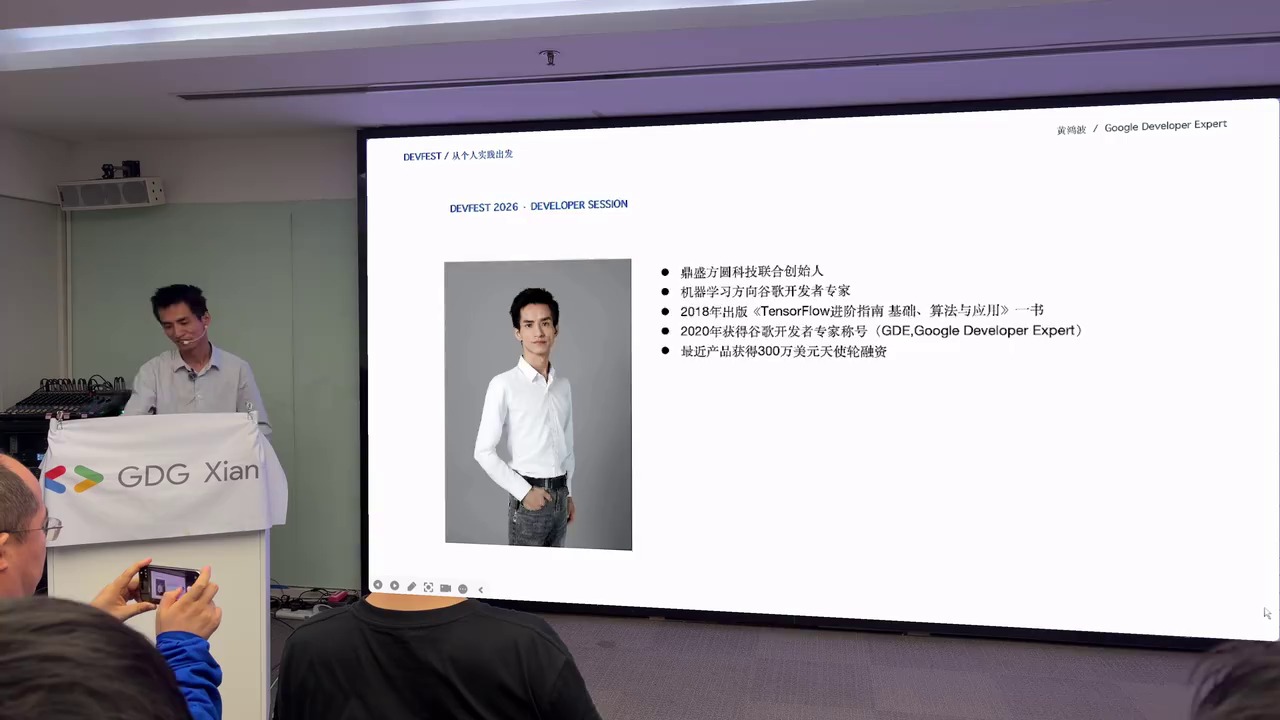
讲者黄鸿波[2]开场把今天的范围交代得很清楚:主要讲 A 股,同时港股、美股他也做(原话还提到"其他的一些"标的,转写不清)。他先做自我介绍:早年在金山带团队,2024 年从金山出来创办鼎盛方圆[3],最近拿到 300 万美元天使轮融资。
然后他说了一句很有代表性的铺垫——"先看张图啊,因为有图才会有这个说服力"。
这张成绩单是他整场论证的起点:个人账户开户至今收益率 193.45%(复利[4]口径),最近一年收益率 38.66%,示例区间标注为 2019-01 至 2026-10;右侧是净值曲线与持仓明细的小图。他补充说美股账户是从 5000 美元做到 14000 美元左右。这些数字后面在 Q&A 环节会被重新解释(不是单一年份、换过很多策略),此处先按下。
01:09—03:30 什么是严肃量化:把想法写成规则,用数据检验
进入正题,他给的第一版定义绕了一圈才落地:"用明确的规则、数据、特征,通过 AI 也好、通过量化方法也好,把你自己的想法变成一个能够实际落地、能替你自动分析交易的工具或产品。"随后压缩成一句更锋利的话:
其实就是把主观的想法,变成一个被动的表达。
他强调这个定义与大众印象相反:很多人以为量化是"AI 帮我炒股、AI 帮我赚钱",但他认为量化的真正作用是帮助你把策略、把你的想法做分析做回测,让你知道它是对还是错。
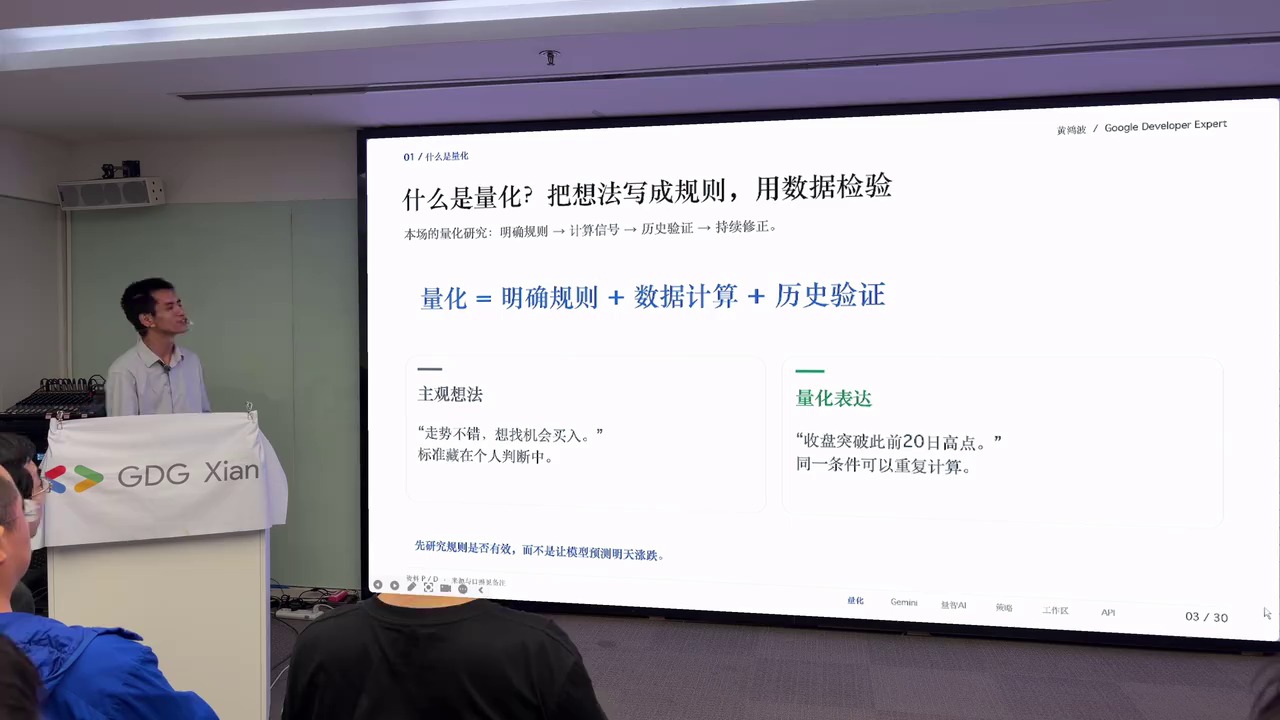
幻灯片把这一页做成了一张对照表,这是他全场反复引用的核心公式:
- 量化 = 明确规则 + 数据计算 + 历史验证
- 左侧"主观想法":"走势不错,想找机会买入"——标准藏在个人判断中;
- 右侧"量化表达":"收盘突破此前 20 日高点"——同一条件可以重复计算。
他现场举的例子也印证这一点:"我觉得这支股票走势不错"是判断,而"它的收盘价突破此前 20 日均线的最高价"才是可以计算的条件;程序按这个标准设置指标与条件,回到历史行情里观察表现。
接着他连续拆掉三个误解:
- 量化不等于一定能赚钱——它检验的是策略好坏,不是收益承诺;
- 量化不等于必须做高频交易[5]——低频、中频同样可以做量化;
- 最重要的落点不是技术,而是"研究的过程能够被重复执行和检查"。
于是有了第三版、也是全场最完整的定义:把投资判断变成可计算、可验证的一套规则。这套规则有六个面向,构成幻灯片上的六宫格。
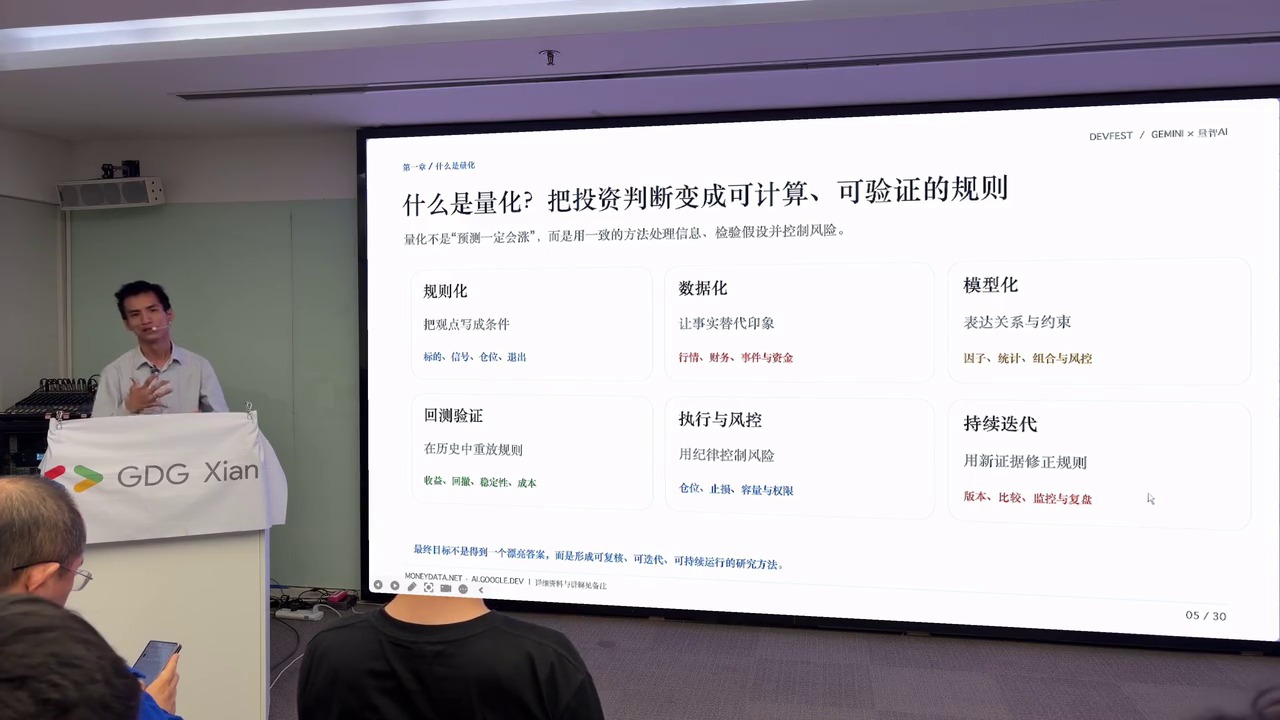
| 面向 | 含义 | 关键词 |
|---|---|---|
| 规则化 | 把观点写成条件 | 标的、信号、仓位、退出 |
| 数据化 | 让事实替代印象 | 行情、财务、事件与资金 |
| 模型化 | 表达关系与约束 | 因子、统计、组合与风险 |
| 回测验证 | 在历史中重放规则 | 收益、回撤、稳定性、成本 |
| 执行与风控 | 用纪律控制风险 | 仓位、止损、容量与权限 |
| 持续迭代 | 用新证据修正规则 | 版本、比较、监控与复盘 |
他给这页配的注脚同样关键:"最终目标不是得到一个漂亮答案,而是形成可复核、可迭代、可被质疑的研究过程。"他把量化[6]的意义从"赚钱工具"彻底转成了"可检验的研究方法"。
03:30—07:10 从连板选股到交易策略:一个可执行闭环的样子
抽象定义讲完,他用一个在场听众大概率都做过的场景落地。他先调侃"这里应该 90% 的人都炒股吧",然后给出策略:
我只去找最近三天全都涨停板[7]的股票,每天早上 9 点、9 点 10 分、9 点 20 分给你推出来;然后再设置一个条件,给这些股票打分——成交量、换手率之类的;它推出评分第一的那只,你买进去。
他的推理是经验式的:"连续三天涨停,第四天大概就会涨。"这套东西拆开来看,就是"选股条件 + 排序规则 + 推送时点",也就是一个最简单的选股策略[8]。他特别强调,"找三天涨停并按一定规则排序"本身就是策略,把规则转成可执行的代码、把最终结果交给你,就是最简单的选股量化。
在此基础上他加了第二层:交易策略[9](他口述时称之为“交易量化”)。例子是"先上涨、后下跌几个点、再往上涨的时候买入",让程序自动执行。选股量化 + 交易量化 + 自动执行接口(A 股、港股、美股都有),就形成"从选股到买、到卖,每天自动执行"的一整条链路——这是大众口中"程序化运行"的量化。
接着是本场最重要的一个否定命题:量化不是预测。
- 预测是"我预测这只股票今天会涨,所以我买";
- 量化是一个循环:从想法出发,观察市场现象,提出可被证伪的假设,再制定规则——明确买卖条件、仓位、成本。
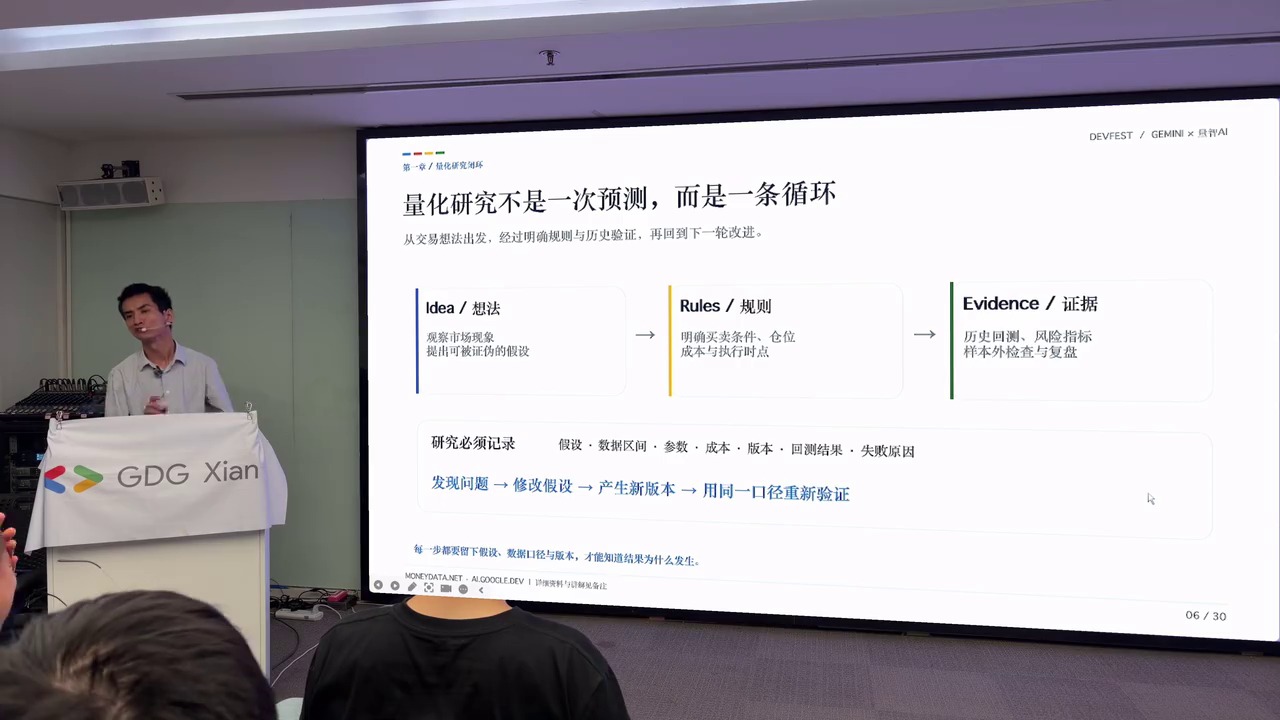
幻灯片把这个循环画成三格:Idea(观察市场现象、提出可被证伪的假设)→ Rules(明确买卖条件、仓位、成本与执行时点)→ Evidence(历史回测、风险指标、样本外检查与复盘)。下方还有两行他反复强调的工程纪律:
- 研究必须记录:假设 · 数据区间 · 参数 · 成本 · 版本 · 回测结果 · 失败原因;
- 发现问题 → 修改假设 → 产生新版本 → 用同一口径重新验证。
他现场用来解释风控的例子非常具体:"我涨 8%,不管后面是涨还是跌,我都卖掉;我跌 5%,不管后面能不能涨回来,我也卖掉。"这就是止盈止损[10]——把仓位[11]与退出条件写死,让纪律替代情绪。
他还顺手回应了一位现场提问者关于"这能不能叫过拟合[12]"的疑问,回答是"可以叫也可以不叫",然后把话题引向 A 股与"数据固定的领域"的本质差异:A 股有 5000 多只股票,每次可以只取 300 只、500 只甚至几十只来测;数据是历史数据,但市场在波动,你不可能知道下一秒涨还是跌。他由此区分了"固定死的数据集里的过拟合"和"随市场漂移的过拟合",这也是后面引出"未来函数"的前置伏笔。
07:10—12:20 历史分钟线回测与"未来函数"陷阱
进入验证环节。他把回测的流程讲成一条可复现的流水线:把选股策略与交易策略写成程序,用历史数据回测——一分钟线、五分钟线、三十分钟线都行——从某个起点(他举例时口误说成"2026 年 1 月 1 号",按上下文应为 2025 年)跑到 10 月 24 日,初始资金 10 万,遵循 T+1[13] 规则,让程序自动执行买卖;如果期末变成 15 万就是赚 50%,变成 8 万就是亏 20%。
回测的价值在于调参的可证伪性。他给了一个极具体的例子:假设你观察到股价每次涨到 7% 就跌下来,而你的卖出阈值设成了 8%,那就可以把阈值从 8% 降到 6%——原本整体亏 10% 的策略,可能变成盈利 2%。"通过不断用程序模拟、用真实的历史数据模拟,让策略的盈利能力相对越来越高。"
这里他做了一个重要的自我限定:"也不叫优秀吧,就是说相对来讲盈利能力越来越高。"这是全场少见的、对"回测优化"这件事本身的警惕。
A 股数据为什么不能简单套用机器学习那一套?他的解释是:分钟线[14]数据虽然是历史的,但市场本身在变化,你没法用一套固定数据集去"训练—验证—测试"然后相信它一定成立。
接着他抛出全场最实用的一个坑:
很多网上的量化平台还会有一个点,叫未来函数。什么意思呢?你训练的时候、你在做回测的时候,用未来的数据来模拟前面的数据,导致看起来很好。
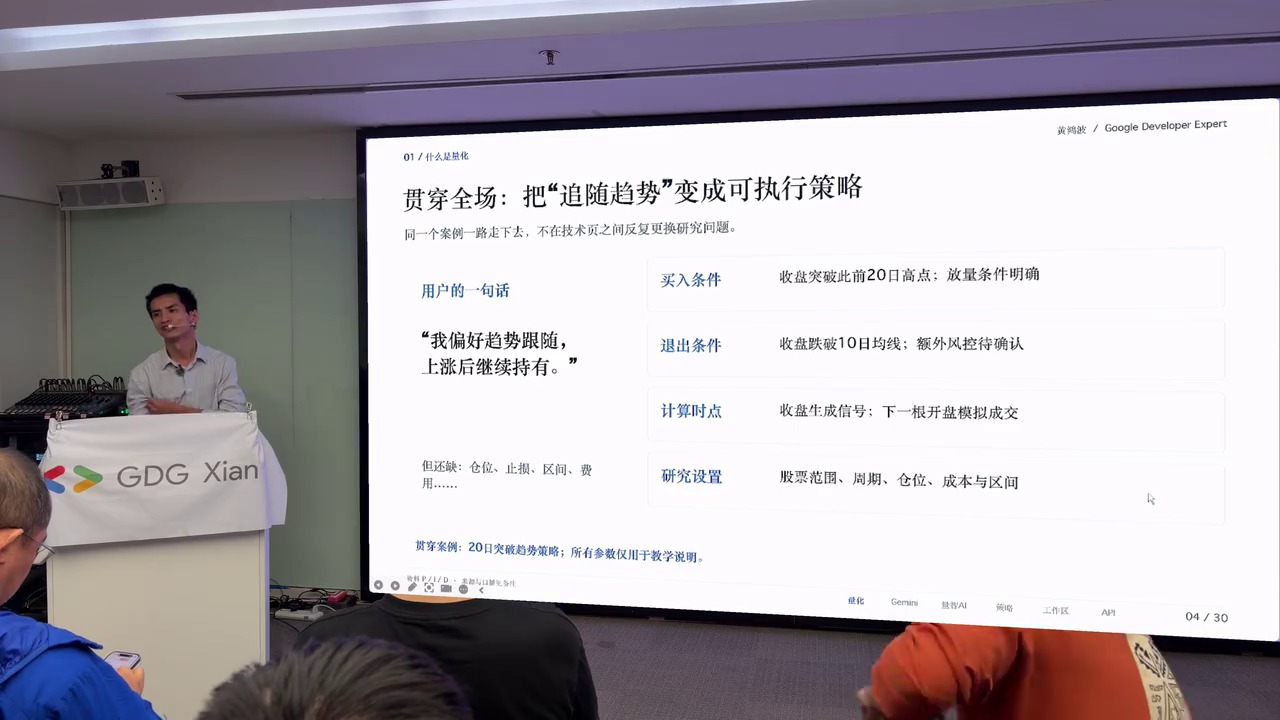
他给的规避原则是流程层面的:无论是自己做量化、选平台、写代码,都要防止"用未来函数去做现在的事"。幻灯片用同一个贯穿案例把这个抽象风险锚定到具体条款上——用户的一句话是"我偏好趋势跟随,上涨后继续持有",落到策略卡上必须逐条落到可执行参数:
| 策略卡字段 | 内容 |
|---|---|
| 买入条件 | 收盘突破此前 20 日高点;放量条件明确 |
| 退出条件 | 收盘跌破 10 日均线;额外风控待确认 |
| 计算时点 | 收盘生成信号;下一根开盘模拟成交 |
| 研究设置 | 股票范围、周期、仓位、成本与区间 |
其中"收盘生成信号、下一根开盘模拟成交"正是未来函数[15]的标准防线:信号只能用当日收盘及之前的信息计算,成交必须发生在下一根 K 线。
随后他把"趋势跟随"这类英文关键词的用户表述翻译成技术规则:"当 5 日线大于 10 日线、大于 20 日线时开始买入",然后等条件反转卖出,每次赚 8 到 10 个点的小波段。这就是传统量化到程序化量化的过渡:先沟通想法,再形成策略,再转成代码,再选股、回测,最后知道策略在真实股票里的买卖效果。
12:20—16:15 为什么引入 AI:让用户不必先成为量化程序员
到这里才是大模型登场的位置。他的回答很克制:引入 AI 的原因是用户不必先成为量化程序员,他要做的只有一件事——"把话说清楚"。
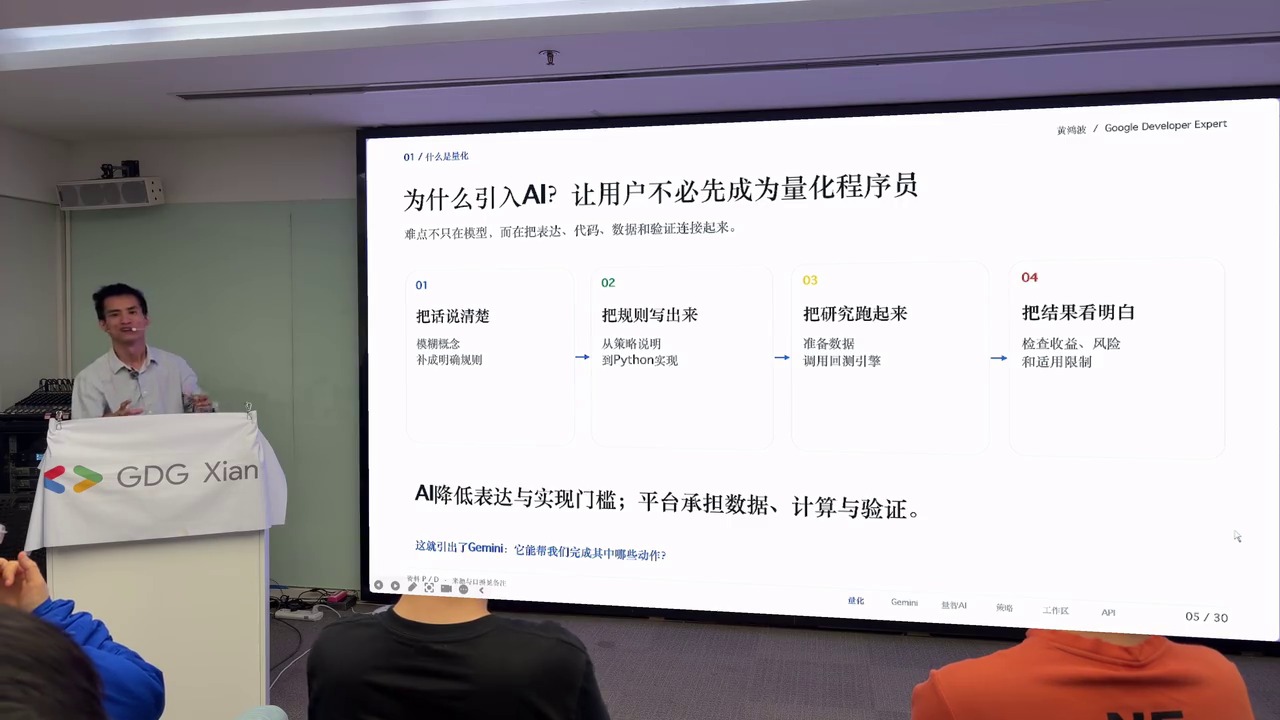
幻灯片把这件事拆成四个动作,这也是理解后面所有产品设计的关键框架:
- 把话说清楚——模糊概念补成明确规则;
- 把规则写出来——从策略说明到 Python 实现;
- 把研究跑起来——准备数据、调用回测引擎;
- 把结果看明白——检查收益、风险与适用限制。
结论句是:"AI 降低表达与实现门槛;平台承担数据、计算与验证。"他现场举的用户表述包括"帮我选一批股票,总体上上涨的,MACD 金叉的,再配一个交易策略,什么时候买、什么时候卖"——这类话人听得懂,但机器要先补全条件才能执行。
然后是全场最"得罪人"的一段:数据来源。
大部分不是专业搞量化的、但又想通过量化赚钱的人,用什么方法呢?用 WorkBuddy、用 Claude(指各类 AI 编程工具)。我不说这些不好——这些写的代码是对的,但这些的数据可能是有问题,因为你并不知道他的数据是哪来的。他可能从这个网上找一家、那个网上找一家,最后一核对,可能不对。
为什么不对?他把原因归结到复权[16]:前复权、后复权、以及"推荐"用的口径,不同平台、不同数据源可能都不一样。把不同口径的数据拼到一起,回测[17]结果一定是错的——"你看见你肯定可能挣了 50%、60%,那实际上到真实数据里你可能是亏钱的"。
他对模型的判断也值得记录:国内可以用 DeepSeek[18],但"量化出身做量化肯定就好"这句话他并不认同——"并不一定,只能说 DeepSeek 相对来讲适合做量化这个事"。而且他明确说 AI 的定位不是替你做交易、替你做判断,而是把你的想法、思路转换成策略,再生成代码去回测。
16:15—17:55 多模型协同架构:Gemini 沟通、Claude 写码、平台跑数
他给出的架构不是"一个大模型包打天下",而是按能力拆成三段:
- Gemini(幻灯片与讲稿中他多次口误说成"GPT",按上下文应为 Gemini)——与人对话,用各种思路方式交流,最后形成一个大策略;
- Claude[19]——把策略交给它生成策略代码;
- 自己的平台——数据与券商[20]合作、采买高质量数据,用一分钟线、五分钟线、三十分钟线做拟合,得到回测结果并做回测分析。
他的原话点出了这个架构的动机:"这里不只是我调了个聊天框,而是把模型能力放在自己的一个平台里。"模型提供理解、生成与推理能力,平台提供数据、计算与验证——这条分工线在下一章被写成了一张独立的幻灯片。
17:55—22:15 Gemini 六大特性与分工:模型理解生成,产品数据执行
他要讲的不是模型排行榜,而是"我用它完成了什么"。先看定位。
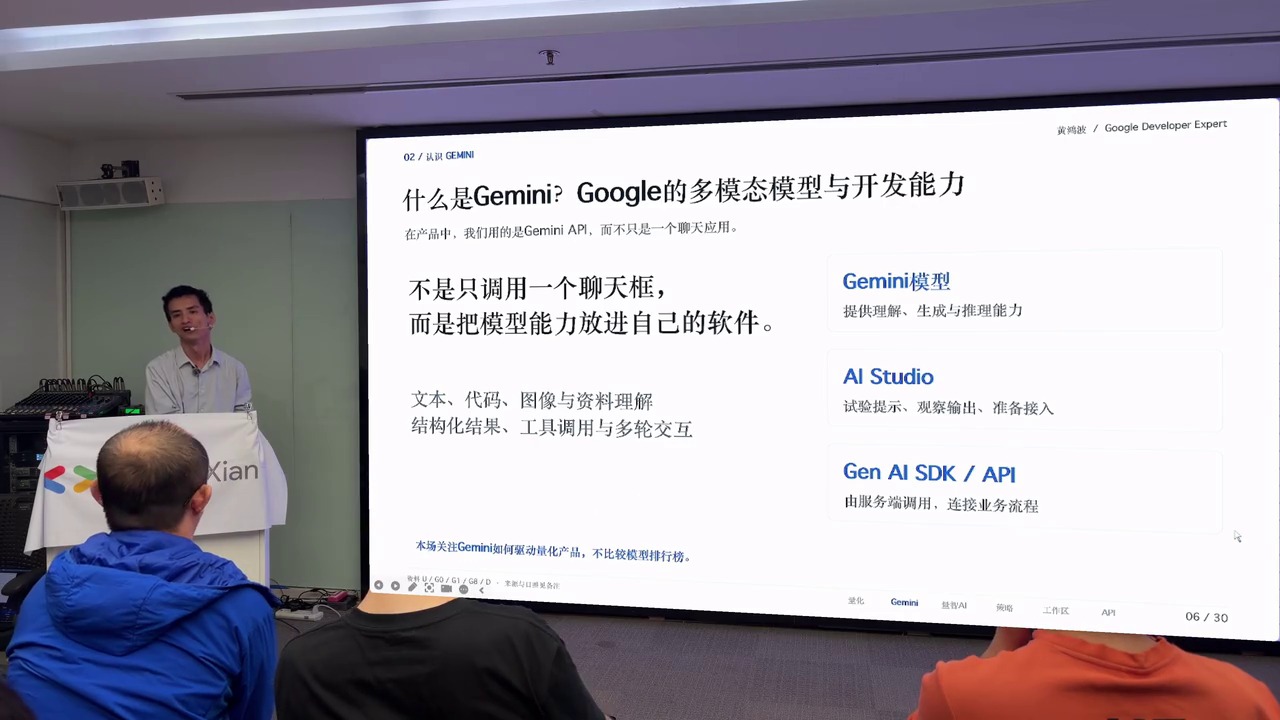
幻灯片把 Gemini 拆成三层:Gemini[21] 模型提供理解、生成与推理能力;AI Studio 用来试验提示、观察输出、准备接入;Gen AI SDK / API 由服务端调用、连接业务流程。核心句是"不是只调用一个聊天框,而是把模型能力放进自己的软件"。
六大特性的对应关系如下。
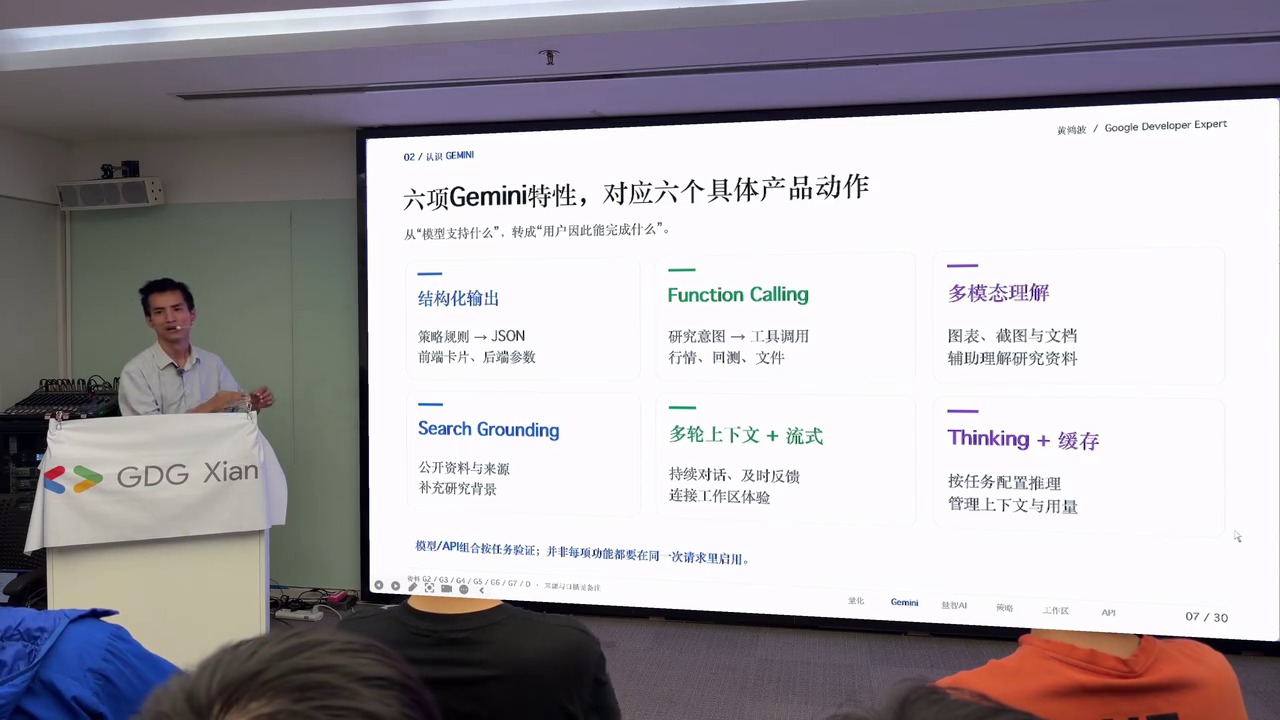
| 特性 | 在产品中承担的动作 |
|---|---|
| 结构化输出[22] | 策略规则 → JSON;前端卡片、后端参数 |
| Function Calling[23] | 研究意图 → 工具调用;行情、回测、文件 |
| 多模态理解[24] | 图表、截图与文档,辅助理解研究资料 |
| Search Grounding[25] | 公开资料与来源,补充研究背景 |
| 多轮上下文 + 流式 | 持续对话、及时反馈,连接工作区体验 |
| Thinking + 上下文缓存[26] | 按任务配置推理,管理上下文与用量 |
讲者口述版本比表格更细:结构化输出把策略规则转成 JSON,前端的卡片、后端的参数都靠它;Function Calling 让他能调用平台里的数据、参数、工具与回测;多模态理解可以"理解图表、截图、生成图表";Google Search 用来上网找数据、新闻、舆情,也就是他说的"舆情系统"靠 grounding 做;此外还有多轮上下文与流式输出。他也提醒:"模型/API 组合按任务验证,并非每项功能都要在同一次请求里启用。"
紧接着是本场设计上最诚实的一页——责任边界。
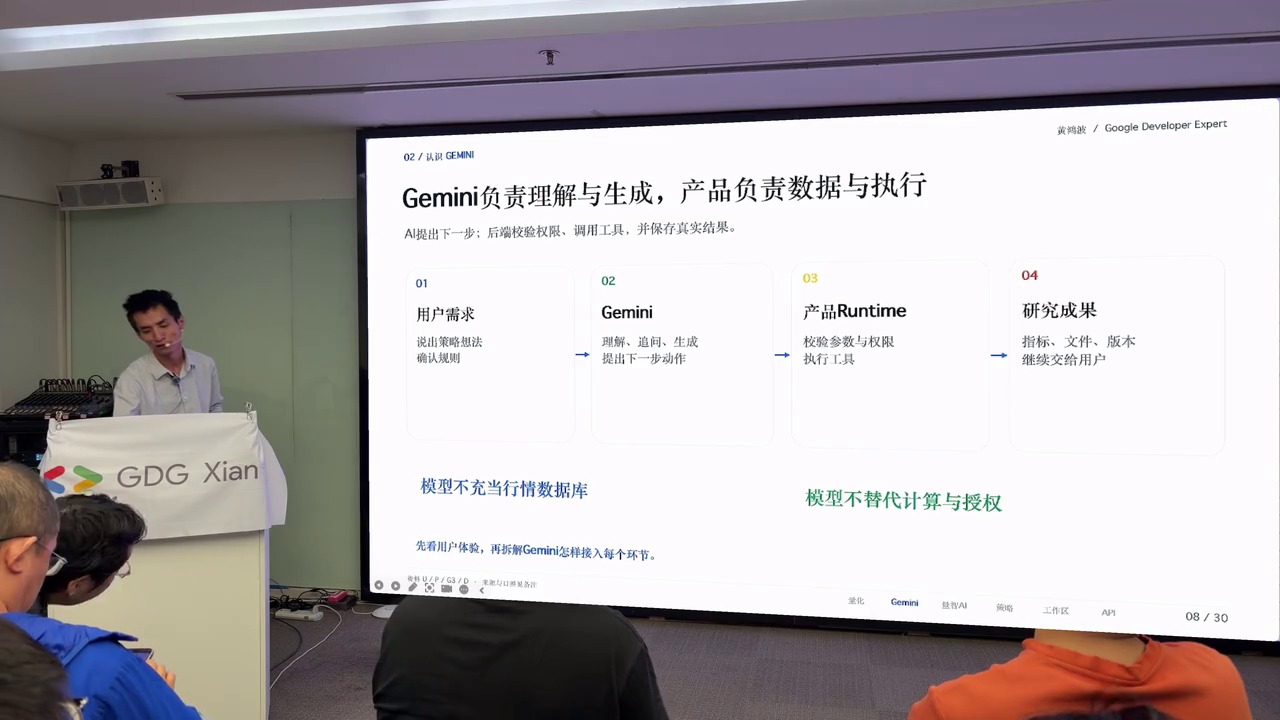
四段式流程是:用户需求(说出策略想法、确认规则)→ Gemini(理解、追问、生成、提出下一步动作)→ 产品 Runtime[27](校验参数与权限、执行工具)→ 研究成果(指标、报告、文件)。两行结论被单独放大:
- 模型不充当行情数据库
- 模型不替代计算与授权
这两句话解释了他为什么反复强调平台:大模型负责把模糊意图变成明确指令,但价格、回测、权限、审计必须回到确定性的后端。报告页里的图表、文件、精确数字、结果计算,最终由模型组织呈现,来源却必须是平台算出来的。
22:15—34:50 开发者硬核视角:AI 工作区、Skills 与回测执行链
这一段是全场信息密度最高的部分,也是他自己产品"量智 AI[28]"的设计说明。
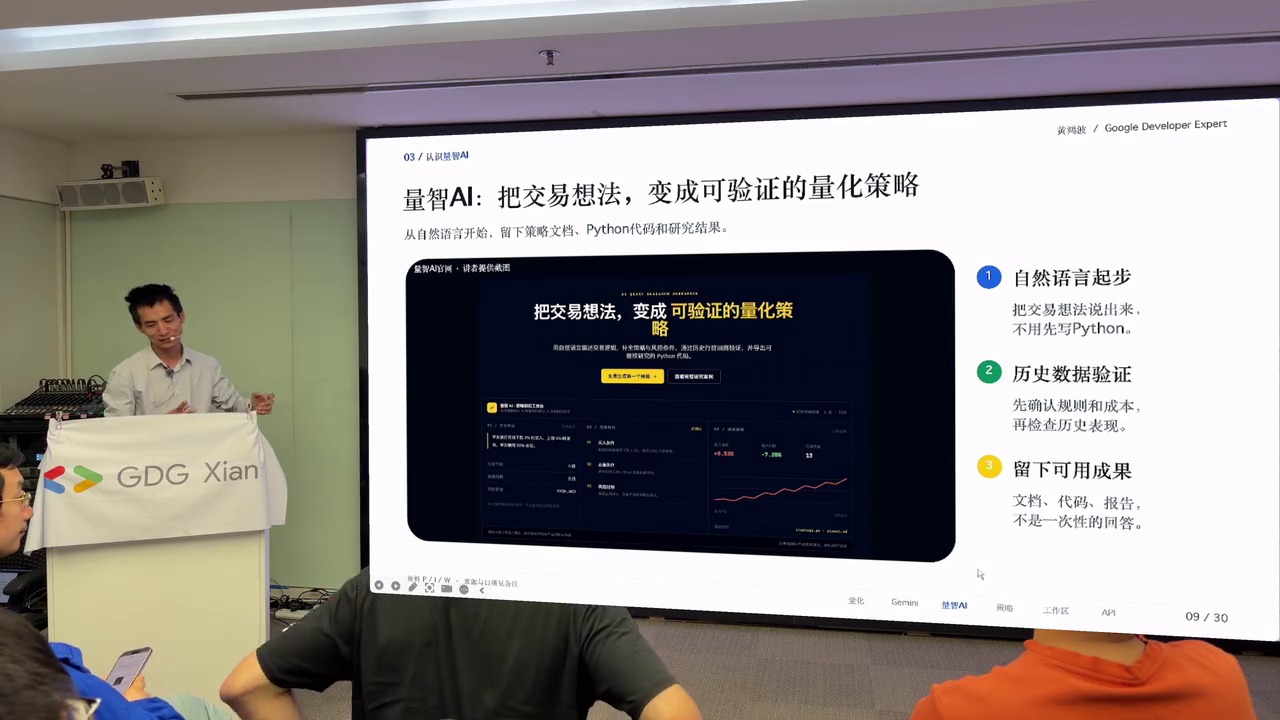
产品的对外承诺被压缩成三步:自然语言起步(把交易想法说出来,不用先写 Python)→ 历史数据验证(先确认规则和成本,再检查历史表现)→ 留下可用成果(文档、代码、报告)。首页截图上能看到一个具体策略的指标卡:累积收益 +8.53%、最大回撤[29] −7.20%、交易 13 笔(这是他演示的另一个策略,与后文"产品总览"的数字不是同一组)。
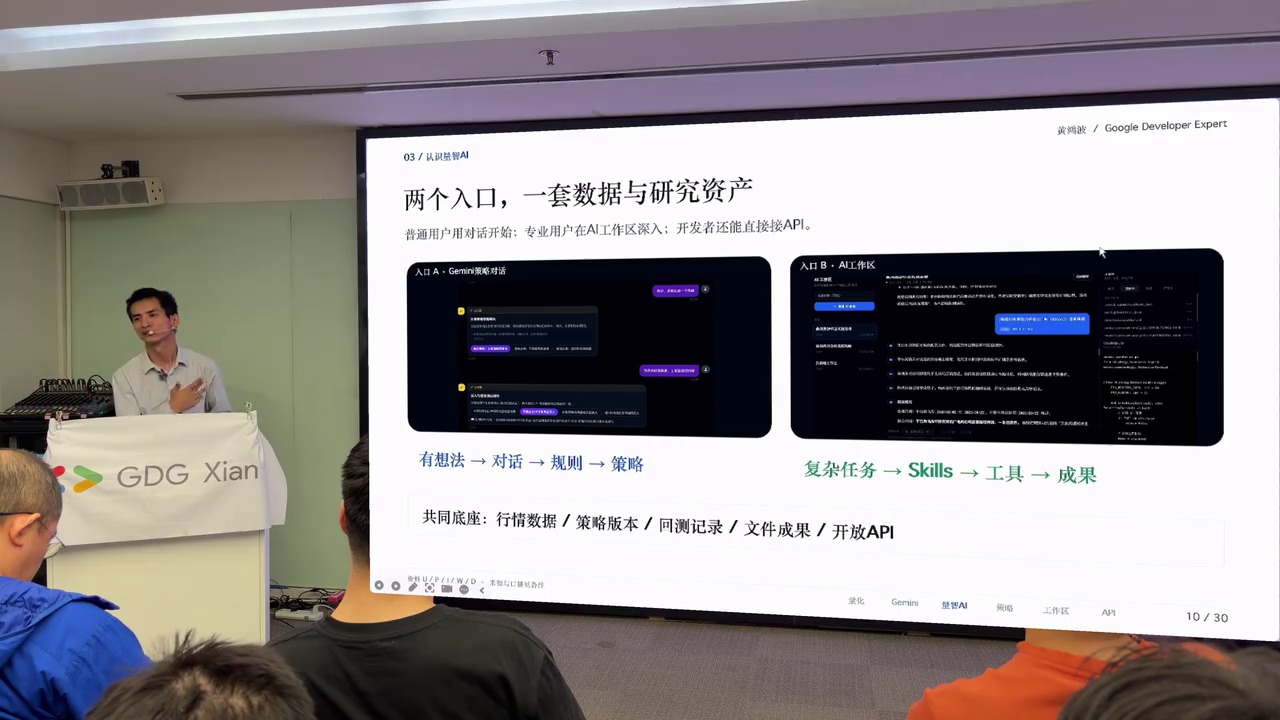
他给两类用户留了两个入口,共享同一套底座:
- 入口 A · Gemini 策略对话:有想法 → 对话 → 规则 → 策略。面向不会写代码的人,"我父亲这一代的炒股的人,他们不会写代码,但他们知道怎么买,他就说给 AI,AI 给他生成这样的策略"。
- 入口 B · AI 工作区[30]:复杂任务 → Skills[31] → 工具 → 成果。面向"会 Codex[32]、会 AI"的程序员。
- 共同底座:行情数据 / 策略版本 / 回测记录 / 文件成果 / 开放 API[33]。
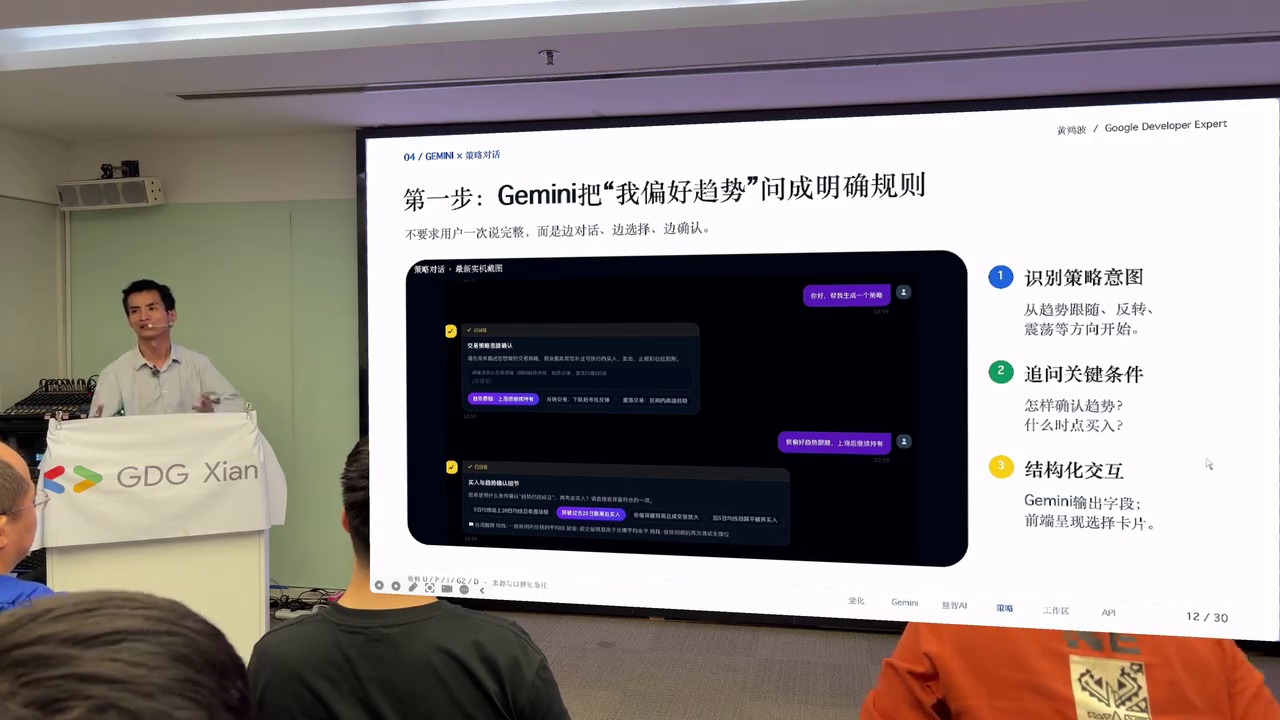
他演示了"追问"为什么重要。用户只说"筛选出最近三天都涨停的股票",系统会反问:你是要连续三天涨停,还是中间可以有非交易日?他举的另一个例子更典型——用户说"第 30 个交易日平均成交量大于 1000 万",系统会追问"你说 1000 万以上,是指 1000 万股还是 1000 万元?"答完之后才继续补全策略。这一步在幻灯片上被命名为"识别策略意图 / 追问关键条件 / 结构化交互"。
他还给了一条完整的选股策略示范:全部市场可用,排除 ST、次新股、停牌股;价格 10—20 元之间;以前 30 个交易日的收盘价为基准,上涨超过 5%;成交量 1000 万以上。
数据层面他给了几个可核对的数字:数据库里大约有 1 TB 多数据,涵盖一分钟线、五分钟线、三十分钟线、六十分钟线与日线,从 1990 年到现在;而且"都不是实时去爬,全都是确认版的数据"。
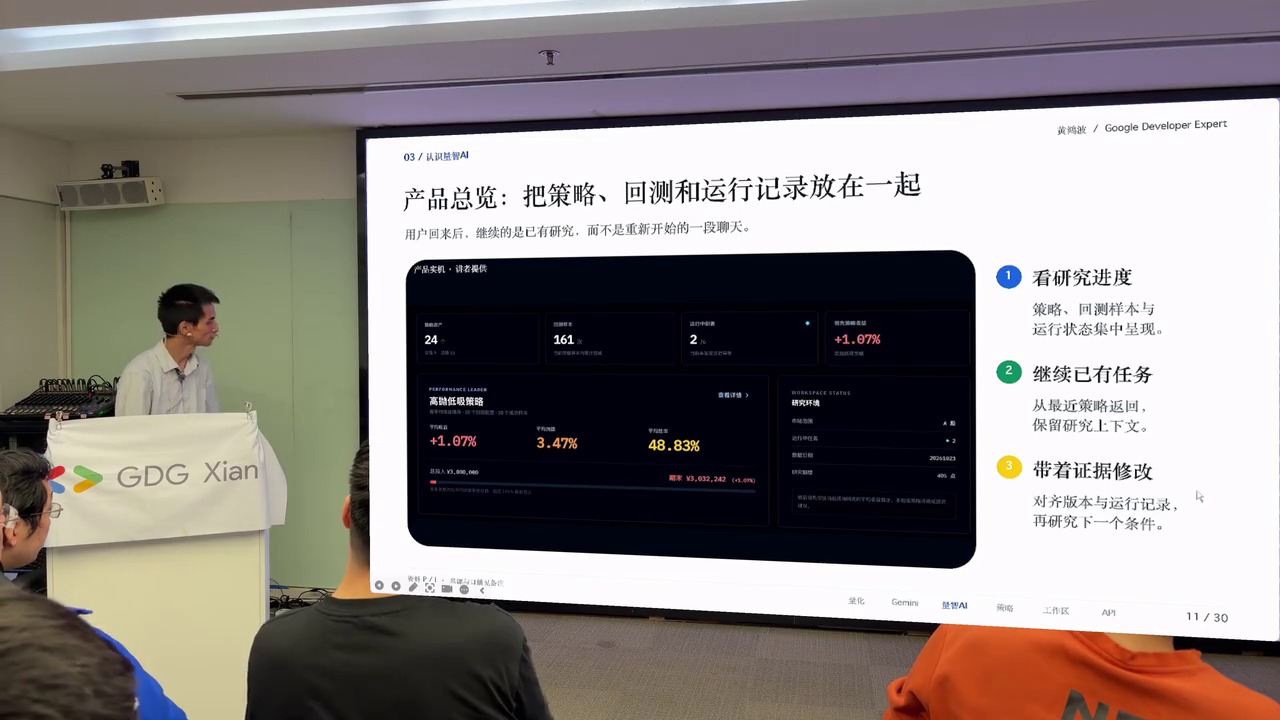
这张总览页值得逐项读:顶部四张指标卡依次显示 24 个(策略资产类)、161 次(回测类)、2 个(进行中任务类)与 +1.07%(领先策略表现;卡片小标题在录制画面中偏糊,此处按数值含义归类)。下面的 "PERFORMANCE LEADER" 卡里是高抛低吸策略:平均年化收益[34] +1.07%、平均回撤 3.47%、平均胜率 48.83%,总投入 ¥3,000,000,期末 ¥3,032,242(+1.09%)。讲者口述时把这组数字说成"平均回撤 3.47%、收益率一个多点、30 万变 303 万",数字与图上一致(图上本金为 300 万,讲者口述时少说了一个零)。这是他自己承认的一个"失利"样本,正好对应他前面说的"量化不等于一定赚钱"。
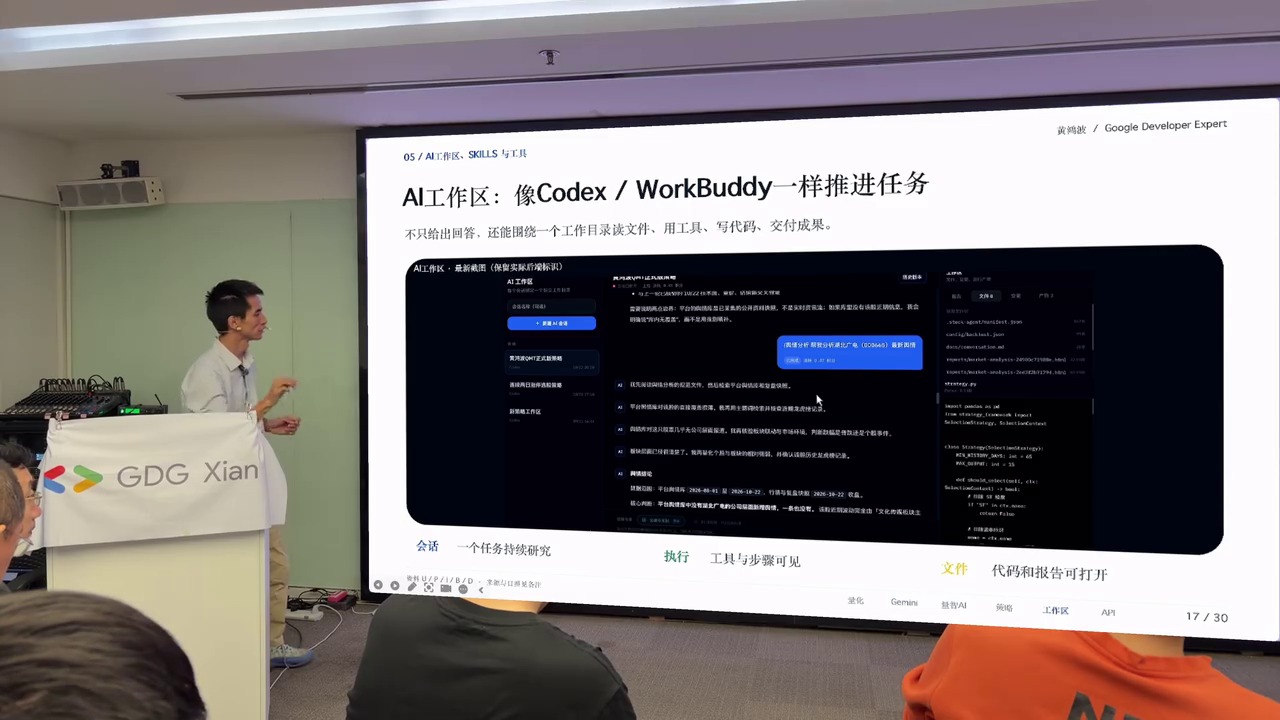
产品里正在做的 AI 工作台,被他直接对标 Codex 与 WorkBuddy[35]:"就像 Codex 或者 WorkBuddy 一样去推进任务,去跟它聊。"他给的演示指令是"帮我分析一下湖北广电的最新舆情"——系统先去读舆情分析的 Skills 规划文件,再到平台里取数、解读新闻与报道。
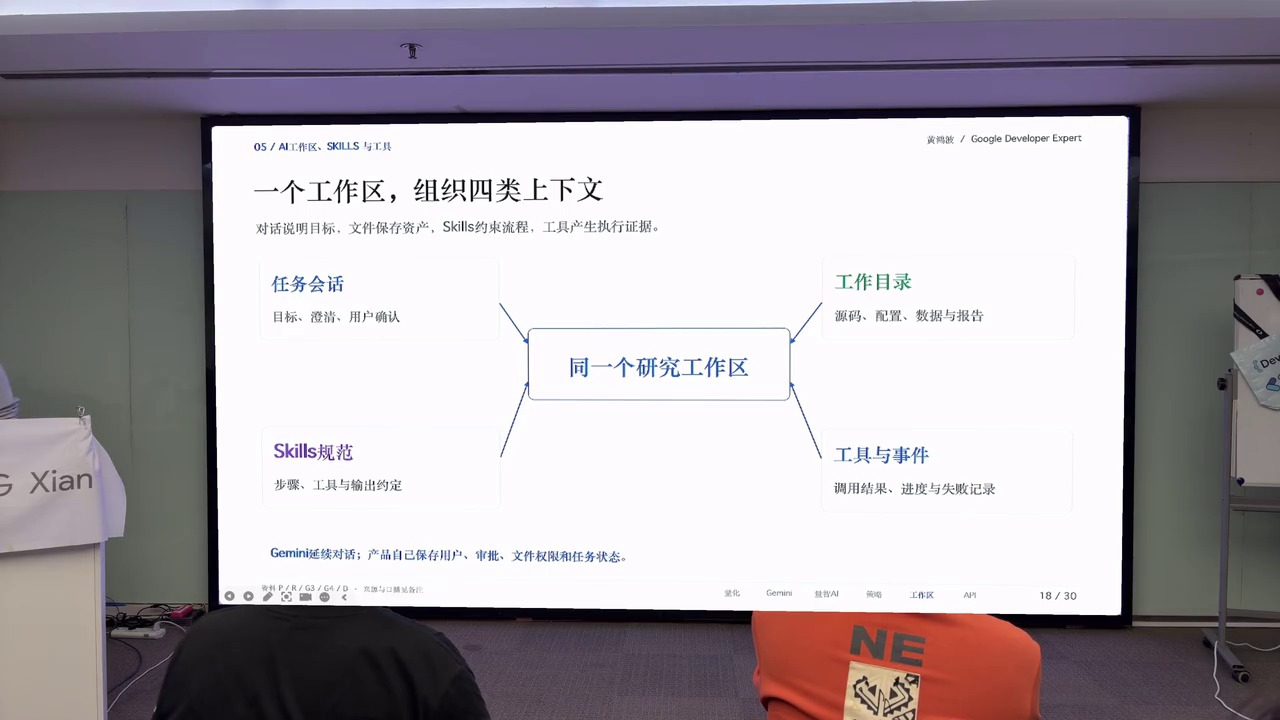
他认为一个能持续工作的 AI Agent[36] 需要四类上下文,这是全场最有复用价值的设计观点:
- 任务会话:目标、澄清、用户确认——"我这一次到底要做什么";
- 工作目录:源码、配置、数据与报告——"当前目录有什么代码、什么配置、什么资料";
- Skills 规范:步骤、工具与输出约定——"完成任务应该遵循哪些 Skill";
- 工具与事件:调用结果、进度与失败记录——"有哪些工具可以用,能产生什么结果"。
分工随之明确:模型负责结合这些信息提出下一步;Runtime 负责任务与文件的执行;前端展示真实的工具调用与结果;多轮对话承接协议、状态与文件归属。整套流程覆盖"从写策略,到数据、到回测、到研究,最后到报告整理"。
他对 Skills 的定义也很工程化——一个 Skill 要回答:输入是什么、工具是什么、能读什么、能执行什么。他以舆情 Skill 为例,接了 Google Search,去找 A 股、美股实时新闻舆情,做公开行业信息的处理。
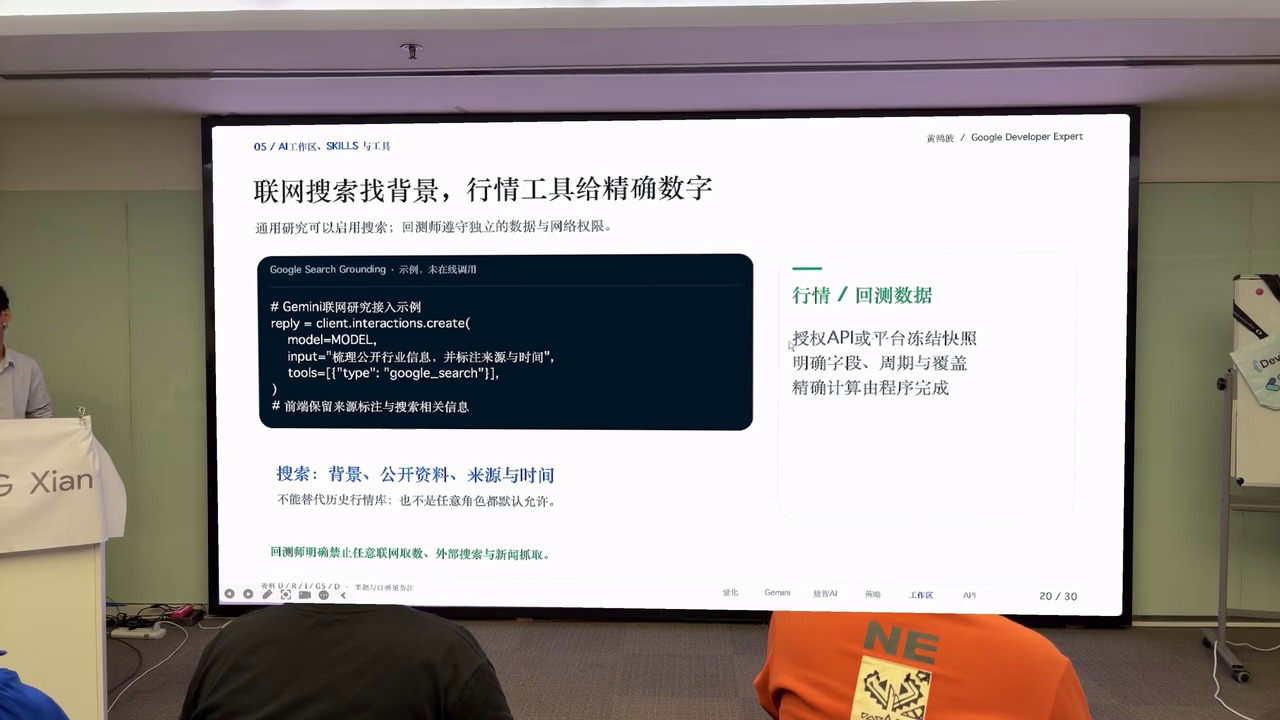
这一页给出了边界清晰的分工示例:联网搜索负责"背景、公开资料、来源与时间",行情与回测数据负责"权威 API 或平台冻结快照、明确字段、周期与复权,精确计算由程序完成"。幻灯片上的示例代码(tools=[{"type": "google_search"}],"梳理公开行业信息,并标注来源与时间")也说明了一件事:搜索负责找证据,不负责算数字。
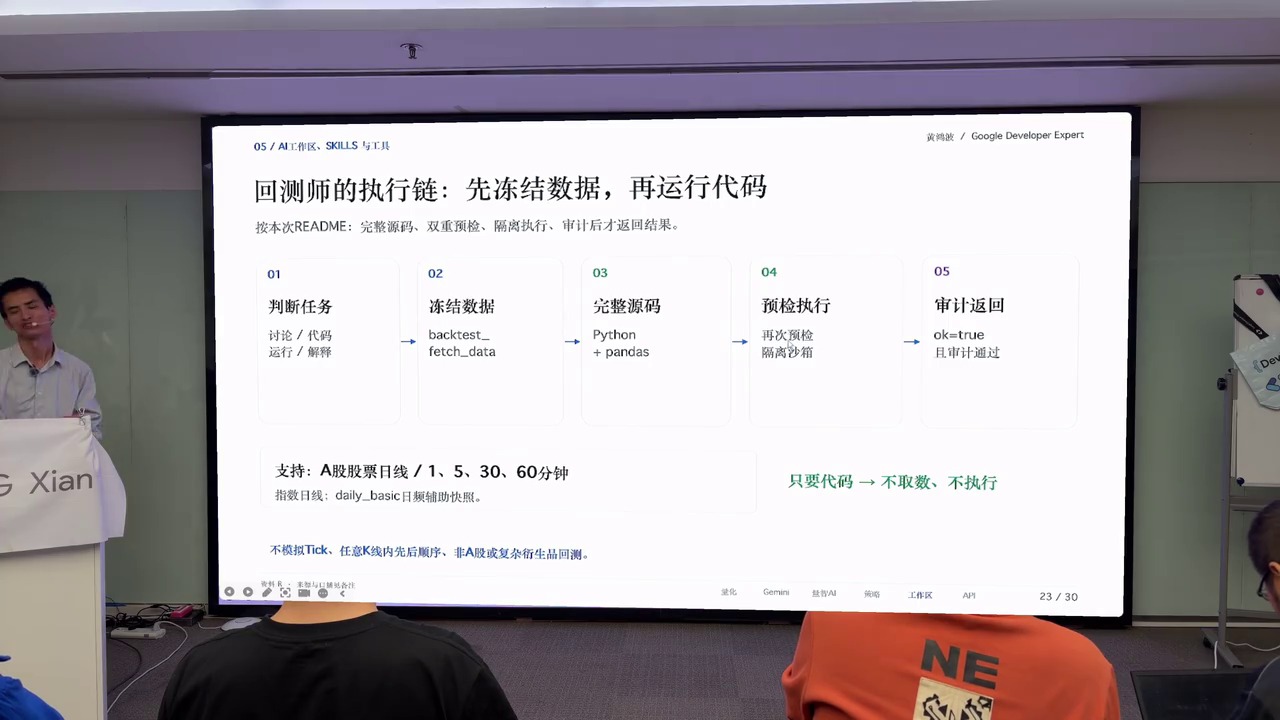
这是他解释"为什么回测可信"的核心论证。他把回测执行拆成五步:
- 判断任务:讨论 / 代码 / 运行 / 解释;
- 冻结数据:
backtest_fetch_data——先把数据固定下来; - 完整源码:Python + pandas;
- 预检执行:再次预检、隔离沙箱;
- 审计返回:
ok=true且审计通过。
支撑这一点的逻辑非常干净:"数据是固定的,代码是固定的,它的结果一定是固定的。"所以"帮我找出连续五天都涨停的股票"这句话,在哪个平台里跑,最终结果都应该一样——因为全 A 股连续五天涨停的就那些,它不会变。支持的范围是 A 股股票日线 / 1、5、30、60 分钟,指数日线走 daily_basic 日频辅助快照。底部还有一条硬规则:只要代码 → 不取数、不执行。
这个"数据先冻结"的隔离沙箱[37]设计,其实就是他前面批评"AI 随便找数据回测"的工程解法:把不可控的数据获取挡在回测之外。
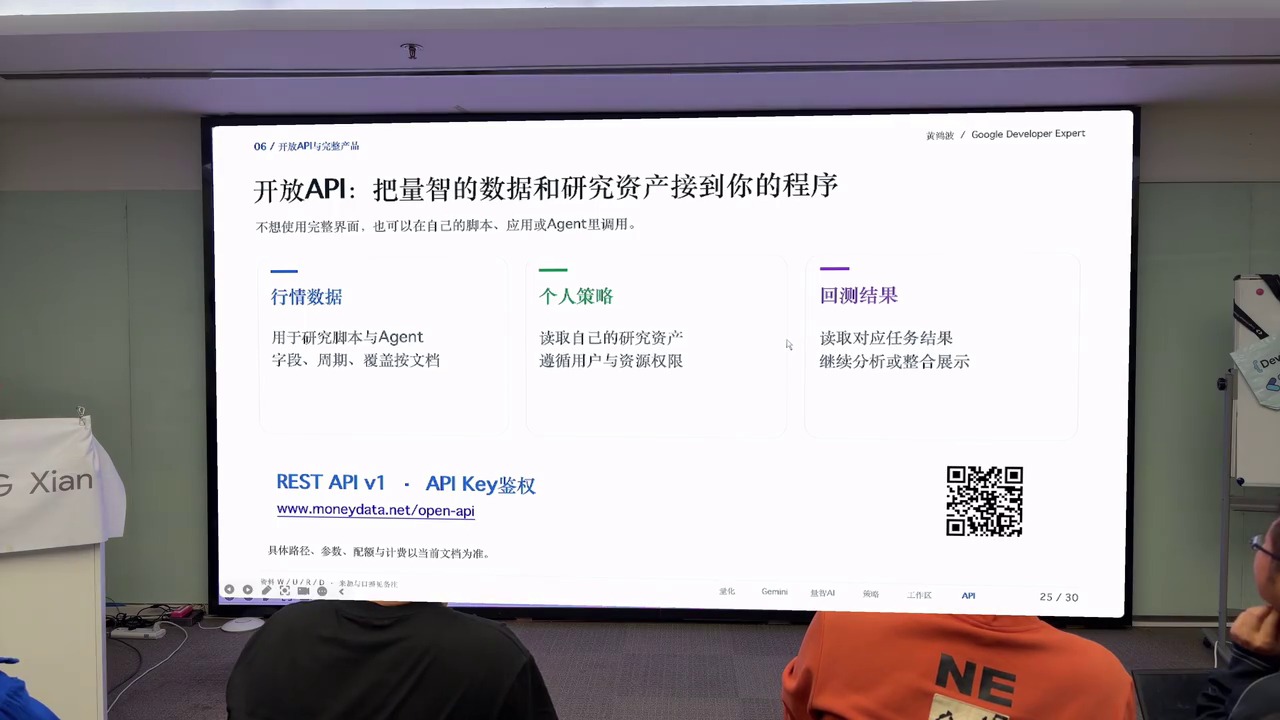
最后一块是开放 API:REST API v1,API Key 鉴权,地址 www.moneydata.net/open-api,对外提供行情数据(用于研究脚本与 Agent:字段、周期、覆盖按文档)、个人策略(读取自己的研究资产,遵循用户与资源权限)、回测结果(读取对应任务结果,继续分析或整合展示)三类能力。他的态度是"不想使用完整界面,也可以在自己的脚本、应用或 Agent 里调用"。
他补充说平台里每天还有复盘、市场分析、实时资金流这些能力,也是 Skills、工具与研究底座的组合,"不仅仅是用了 Gemini,还用了一些其他的模型"。
34:50—46:00 平台实操演示:从策略编排到每日盘前推送
演示前有一段社交缓冲(加微信、建群),随后进入真实产品。他的产品域名被他解释成"money AI","money 加 AI 就是钱和数据"。登录后先看工作区。
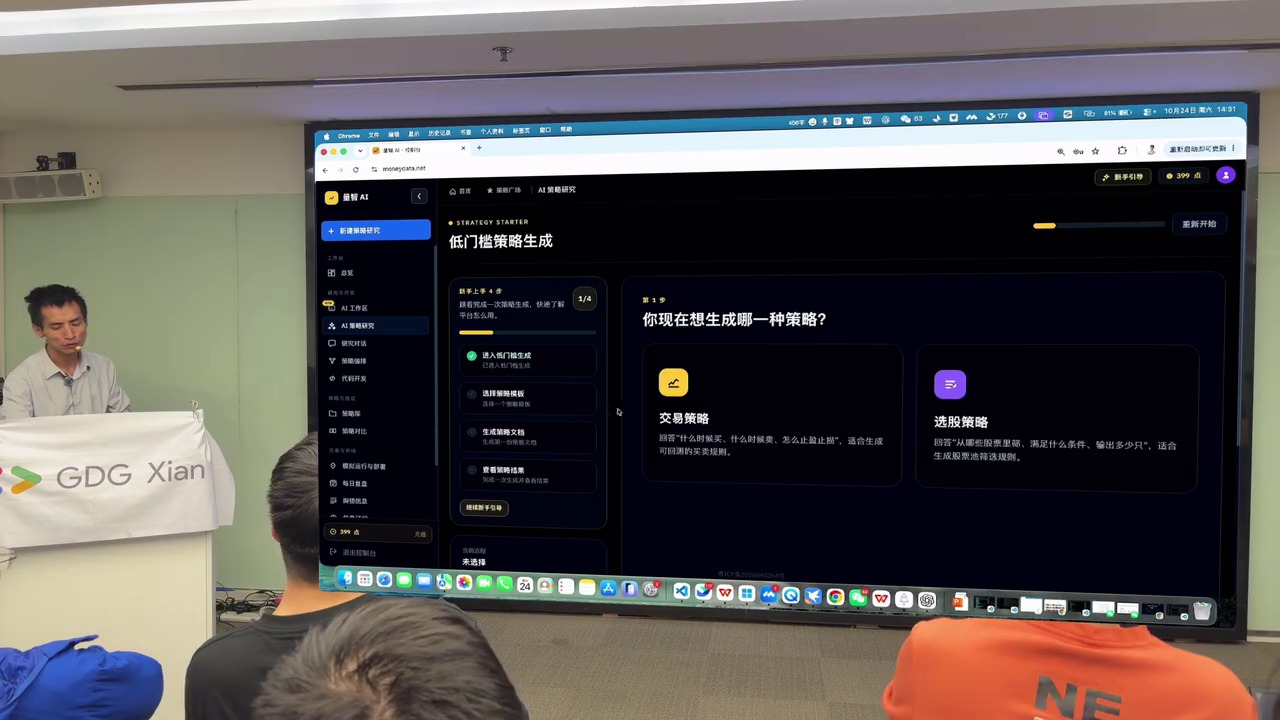
演示的骨架是"策略编排":
- 先有一个选股策略,运行后选出一堆股票;
- 每只股票再经过一个交易策略,产生买卖动作;
- 两者串联运行,最后得到一个回测报告。
他还演示了"特征对比":随便拿一只股票,选开始日期(例如 26 年 9 月 1 日到 10 月 22 日)、选一分钟线、选多个策略,就能横向比较不同策略的盈利率、回撤等指标。
第二个演示点是自动化推送:让某只股票的策略每天运行,"我每天早上 9 点、9 点 20 分,通过邮件和微信推送";运行完把结果推到微信。他展示了自己每天早晨 9:20 自动跑策略的推送记录,并说自己"跟着这个买,百分之四五十吧,还好"。同时展示的还有每日复盘、实时舆情[38](10 月 24 日的舆情、涉及哪些股票)与市场资金流(交易日每三分钟更新一次)。
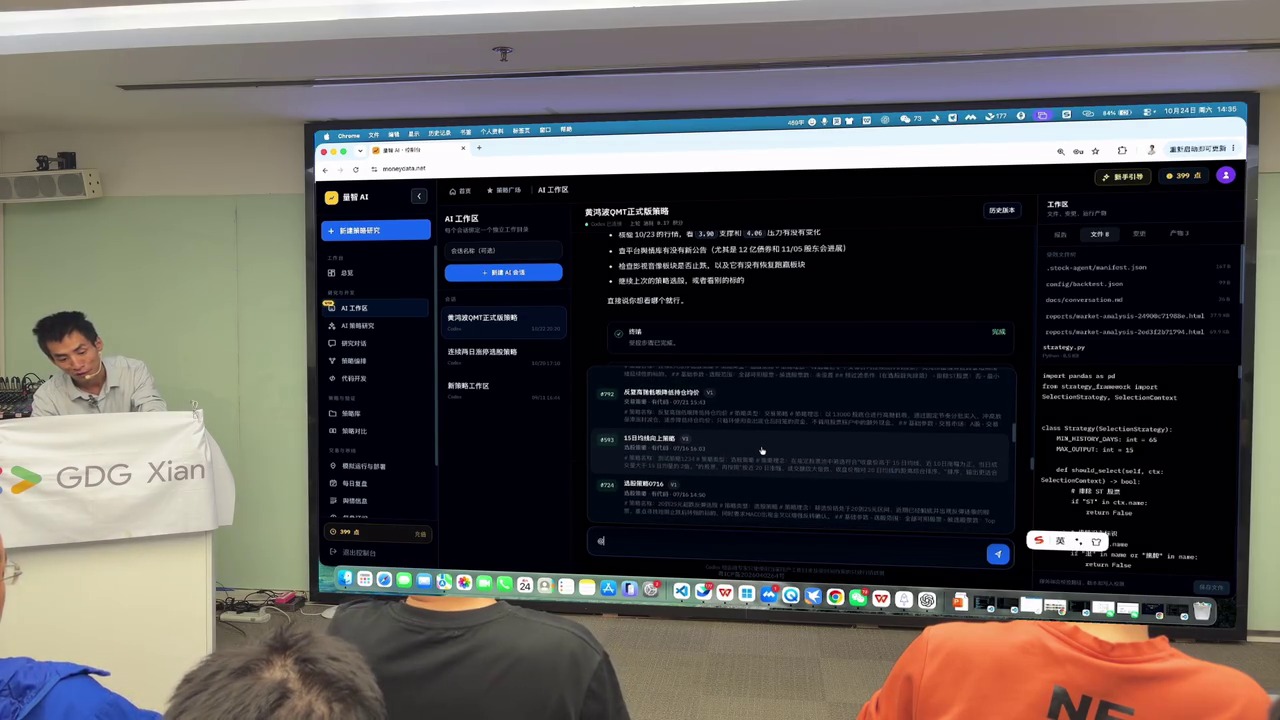
第三个演示点是 Skill 驱动的分析:工作区里集成了一堆 Skill(舆情分析、新策略、导入策略等),他直接说"帮我分析一下这个策略",系统就去读策略文档、读数据、读舆情、读信息,然后给出分析结论——包括结论规格、方向、打分、实际表现、条件、股票池、核心问题。
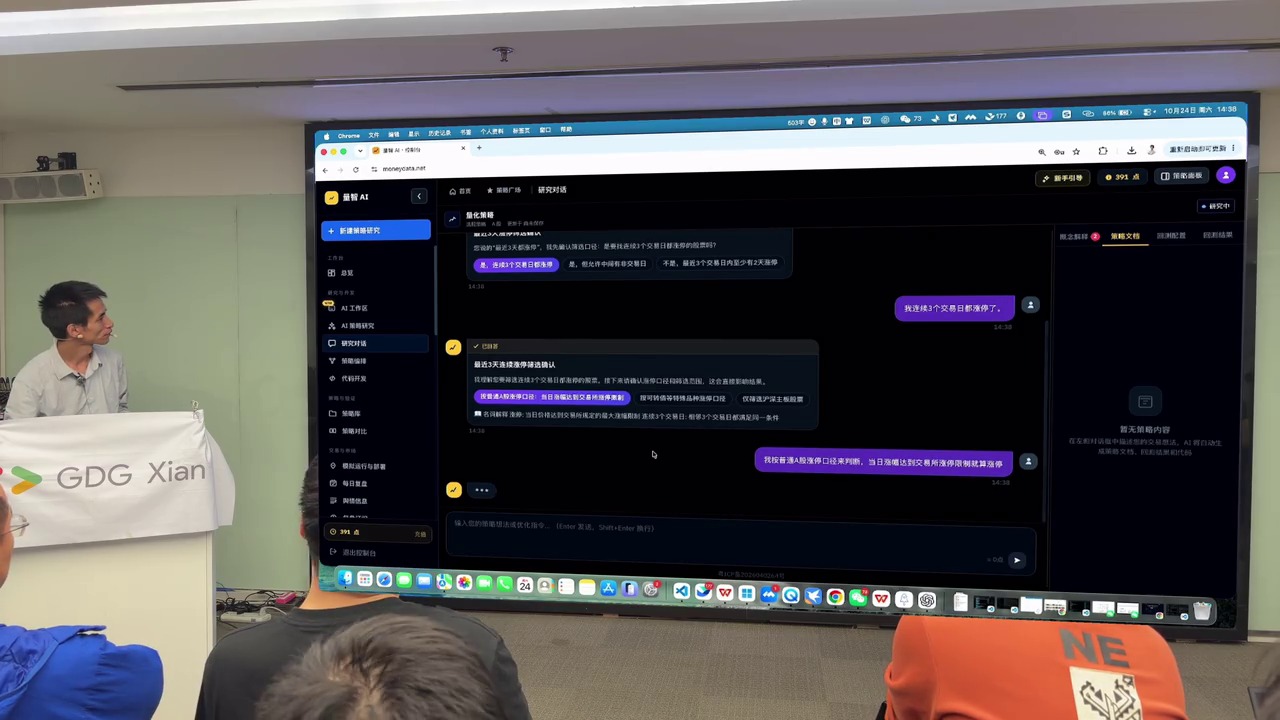
然后是最能说明"追问"价值的一幕:他新建一个策略包,只说"筛选出最近三天都涨停的股票",对话框立即反问"你是要连续三天都涨停,还是中间可以有非交易日";他随便选完,策略文档就形成了。之后选日期、执行,系统先生成 Python 代码,再用底层数据回测,代码生成完开始执行选股,因为要查数据库,大概要一两分钟,最后给出选股结果(他提到新华传媒)。他现场对了一下行情:"如果真买了,是不是昨天就这样?"——用来证明策略不是事后编的。
他接着大方地把"可下载"这件事说透:不只是报告,还包括源码、回测框架代码、交易明细,"这些代码是直接可以去执行的"。有人问"只给代码不给数据怎么办",他的回答是开放 API:用 Python 调市场数据、回测数据、策略数据。
演示收尾他讲了一个用户案例:有人在群里说用他平台"最近好像赚了七八十个点",他特意说明"不是给我打广告,是别人问收益效果怎么样,他自己说的"。他把它定性为"现货的策略"。
46:00—01:01:35 现场问答:接口、合规、胜率、护城河、指数与舆情
Q1(46:00)交易接口能不能自动化? 有功能,但"好像被我下线了,还没上线",暂不开放。他解释 A 股的现实路径:入金超过十万可以开通 QMT[39] 权限,然后可以用 AI 通过程序自动交易;除招商证券外"基本上都可以"。他提到自己与国金证券有合作,佣金能压到很低的水平(口述为"百分之零点几",未给出精确口径)。招商证券不开的原因他专门问过:"之前有散户用量化出过事,亏了好多,他们就不敢对外开了。"
Q2(47:40)有没有期货、期权的数据? 指数数据都有;期货期权数据"目前没有放,后面准备加"。他演示了可以直接问平台"你这里都有哪些数据",系统会把数据库能力列出来。
Q3(48:40)策略是不是最优的?舆情能不能给投资建议? 这一段是全场的合规红线。他的回答是:按照中国现行法律,任何平台都不能做股票推荐(荐股),也不能做卖点预测;所以"策略本质上是你的策略,不是我的策略"——"如果我把我的策略生成好推荐给你,那我就变成荐股了,这在法律上是不允许的"。
关于舆情他对"实时"做了限定:AI 工作区接的是实时新闻与实时资讯引擎,问它"五分钟之前或十分钟之内有没有什么大新闻"能收到;但它不能替你做决策,只能给意见。具体能给的是:支撑位、压力区间、技术面、观察点、下一个时间窗口(他举例"11 月 5 号"),但"不会告诉你你到哪个点必须买"。
Q4(52:50)真实胜率与收益率? 他先报收益率"大概百分之一百九十几"(口述接近"百分之一百九十六"),然后立刻澄清:其中"一百九"是之前好几个策略的合计,不是一年的,时间跨度是从 2020 年到现在,中间换过很多策略——"不是一个策略从头到尾,那不可能,那我是火神了"。胜率方面:之前用的高抛低吸策略胜率大概 58%(口述还有"8.67"这个不成句的数字,疑为盈亏比或另一指标);现在常用的策略胜率在 50%—80% 之间,"其实是 60% 到 80% 之间,因为最近波动比较大"。
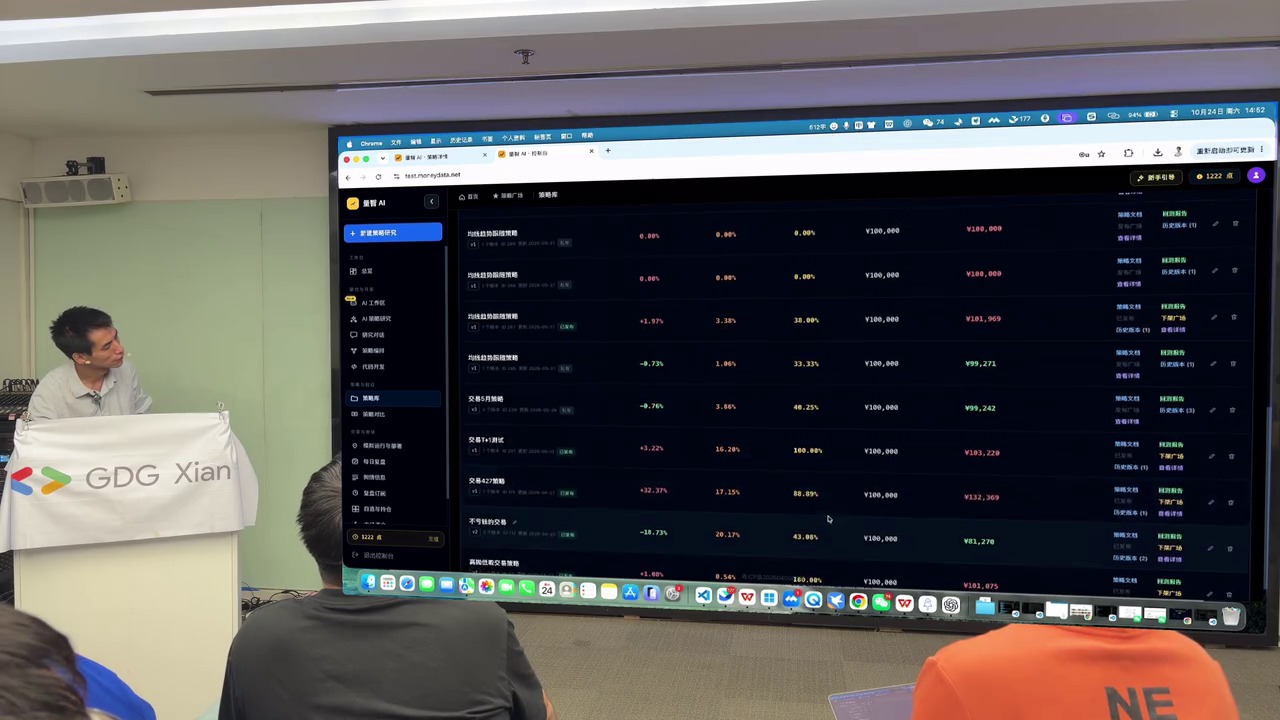
他还打开了"测试广场"演示:那里有其他人发布的策略,收益率与胜率[40]都列在表里,而且每天更新。他也承认自己旧策略的胜率页上"没标出来,后续我标一下"。
Q5(55:40)主要做 A 股单边? 目前主要做 A 股;美股后面会放进去(他 12 月在印尼还有一场演讲);港股最近的活跃度小,做的人不多。
Q6(56:25)既然合规上不能荐股、策略又是每个用户自己的,产品的护城河在哪? 这是他答得最坦诚的一题。他把产品分两类:一类"适合有比较高的护城河"、有投资人投的是未来预期;另一类技术上没有太多护城河,但有资源——"我 12 年前在中国可以说是最大的券商的一方公司,所以现在跟三四十家券商的领导都比较熟,都有合作,包括数据、包括策略,包括跟他们的策略师合作"。他也直说:策略是你自己的,数据可以说是红牌的,但"我这个数据是在小区上买的(转写存疑,疑为'从券商处买的'),也不是独家数据,当然我体量可以很大"。最后一句几乎是行业自嘲:"有些事情是用来拉投资的,有些事情是用来赚钱的。"
Q7(58:40)宽基指数[41]、指数基金、行业基金要不要单独训练? 可以再做一个指数的策略,后面会加;指数历史数据从 1990 年到现在都有,可以做一个跟指数相关的回测——"你看我这从 90 年的到 22 号的都有"。
Q8(60:00)舆情信源很杂、甚至有烟雾弹,怎么去伪存真? 他先复述问题:很多人炒股直接去问大模型,大模型从各个地方找一点信息,结果一是很杂乱,二是数据并不全,或者中间缺了某个点,或者付费口径不一样,最终导致整体判断偏差。他的解法是单一来源:只找券商买相关数据,"我这个数据,是所有的券商都用这一套数据",所以不会出现不同口径拼接的问题——"至少来讲,我们的数据和券商是相同的"。他顺势对比市面上的第三方数据工具(如 AKShare[42]),说那些"其他都是爬下来的"。
最后是收尾感谢与"有问题可以来找我们"。
四、页面描述与评论补充分析
本章是基于视频页面(简介与评论区)的补充材料,独立于视频本身内容,属于页面元信息与观众观点,不是讲者观点,也不构成任何投资建议。
视频描述
页面简介由上传者 GDGXian 撰写,是一份结构完整的"内容提要+嘉宾介绍+资源链接",与视频内容高度吻合,但有几处信息是视频里没有直接口述的,值得单独记录:
- 明确的技术栈表述:简介把架构写成"Gemini(策略沟通与意图提炼)+ Claude(高质量代码生成)+ 平台 Runtime(工具校验与数据执行)"。这与视频中口误频出的版本(多次把 Gemini 说成"GPT")相比,是更权威的文字口径,本报告的术语规范化采用了简介的写法。
- "六大核心特性"的官方命名:Function Calling、上下文缓存(Context Caching)、结构化输出与搜索增强(Grounding)。视频口述时把"上下文缓存"讲成了"心灵管轮/上下纹的多轮",简介给出了正确术语。
- 嘉宾履历的补充:黄鸿波被介绍为"AI 领域创业者、深圳市鼎盛方圆科技 CEO、Google AI 方向开发者专家(GDE[43])、《TensorFlow进阶指南[44]》作者;历任金山西山居高级算法工程师、格力大数据中心 AI 专家"。这段履历解释了视频里"我以前是在金山带团队""2024 年出来创业"的上下文,也解释了幻灯片上"鼎盛方圆科技联合创始人"的表述差异(CEO 与联合创始人)。
- 资源链接:活动照片(Google Photos 相册)、PPT(两个下载源:tmp.link 与 Google Drive)。简介还注明"字幕整理:Gemini 3.8 Flash,剪辑:yitong / 小白"——也就是说,平台方本来做过一份字幕整理,但并未作为 Bilibili 字幕轨发布,本报告只能依靠本地 ASR 重建。
- 七条内容大纲与视频章节基本一一对应(严肃量化 vs 假量化、规避量化陷阱、大模型落地、多模型协同、投研工作区、平台演示、现场 Q&A),可视为讲者准备的提纲。
页面数据(截至抓取时):播放 81、点赞 4、投币 0、收藏 5、评论 2、弹幕 0、分享 4。这是一场线下活动的回放,上线约 4 天,传播量很小。
评论区观察
样本说明:该视频评论区极其稀疏——Bilibili 接口返回的 page.count 与页面统计的评论数均为 2,即全站仅有两条顶层评论,且都没有回复、没有点赞。因此本节无法做"热度前 20 评论"的代表性分析,只能做逐条解读。抓取时间为默认热度排序(sort=2),未经登录、未触发风控。另外,播放器接口的官方章节(view_points)为空,上传者把自己整理的 15 条章节时间戳发在了评论区,这是评论区的实际价值所在。
- 上传者 GDGXian 的章节帖(0 赞):一条完整的 15 行时间戳目录,从"00:00 开场:做量化的初衷与收益复盘"到"01:00:15 现场 Q&A 6:全网杂乱舆情与烟雾弹如何去伪存真?"。本报告第三章的分段直接采用了这组章节。需要注意的是,它与音频里讲者的实际换页节奏存在 10—40 秒级偏差(例如章节标注"07:10 历史分钟线回测与防止未来函数",而对应幻灯片实际在 07:00—10:20 之间推进),属于人工整理的正常误差。
- 平台方的 AI 创作赛推广帖(0 赞):哔哩哔哩Toy 账号的标准化邀请,与本视频主题无关,属于平台自动投放。
可以得出的结论:这段视频目前几乎没有形成观众讨论,因此不存在观众纠错、补充或质疑可供交叉验证。视频里的收益数字(193.45%)、胜率数字(58%、50%—80%)以及"某人赚了七八十个点"的轶事,都没有第三方评论加以核实或反驳;这些表述只能按"讲者自述"对待。相反,简介里的技术栈表述与评论区里的章节目录,是本报告用于校正 ASR 误听的两份最有价值的页面证据。
五、结论与可操作要点
1. 量化的定义应该被工程化,而不是神秘化。 "量化 = 明确规则 + 数据计算 + 历史验证"。它既不承诺赚钱,也不等于高频,更不等于预测。判断一段"AI 量化"是否严肃,看它能否被重复执行和检查。
2. 未来函数是回测最致命的错误,防线在流程里。 标准做法写在策略卡上:信号只用当日收盘及之前的信息计算,成交放在下一根 K 线。凡是"用未来数据回测过去"的平台,回测曲线越漂亮越危险。
3. 数据口径比模型能力更容易毁掉结论。
前复权、后复权、不同数据源拼接,会让 50% 的账面收益在真实行情里变成亏损。讲者的解法是单一来源(券商采购)+ 数据冻结(backtest_fetch_data)后再执行代码。
4. 大模型的正确位置是"翻译器",不是"数据库"或"决策者"。 Gemini 负责理解、追问、生成与结构化;产品 Runtime 负责校验参数与权限、取数与计算。两条边界值得任何做金融 Agent 的人抄走:模型不充当行情数据库、模型不替代计算与授权。
5. 追问质量决定策略质量。 "连续三天涨停"要问清是否允许中间有非交易日;"成交量大于 1000 万"要问清是股还是元。这些歧义不解决,后面所有回测都是错的。
6. Agent 需要四类上下文,缺一不可。 任务会话(目标与确认)、工作目录(源码、配置、数据、报告)、Skills 规范(步骤、工具、输出约定)、工具与事件(调用结果、进度、失败记录)。只给对话历史,Agent 无法持续工作。
7. 回测执行链要可审计。
判断任务 → 冻结数据 → 完整源码 → 预检执行(隔离沙箱)→ 审计返回(ok=true 且审计通过)。另一条硬规则:"只要代码 → 不取数、不执行"。
8. "全自动"的现实边界在合规与接口,而不在模型。 国内任何平台都不能荐股或预测卖点;策略必须由用户自己表达并确认为"用户的策略"。实盘自动化受制于券商接口(QMT,入金 10 万以上可开通,招商证券暂不开放)。AI 能给的是支撑位、压力区间、技术面与观察点,不能替用户做买卖决策。
9. 收益与胜率必须读口径。 讲者自述的 193.45% 是 2019—2026 的累计复利;"190%+"是多策略合计、跨 2020 至今;单个高抛低吸策略的平均年化只有 +1.07%、平均胜率 48.83%、回撤 3.47%。同一场演讲里,这三组数字指向完全不同的结论——这正是"看口径"的最好教学案例。
10. 护城河不在模型,在资源与数据授权。 讲者自己承认技术护城河有限:策略属于用户、数据并非独家。真正的壁垒是与三四十家券商的合作关系与数据授权。这一点对想做"AI+金融"产品的人,比任何技术细节都重要。
六、局限与转写不确定性
- 没有官方字幕。 平台播放器返回的字幕轨为空;简介提到"字幕整理:Gemini 3.8 Flash",但那份字幕没有随视频发布。本报告的文本全部来自 faster-whisper
large-v3本地转写(GPU / float16,分 4 段 900 秒+重叠合并,共 1711 段),中文识别整体质量良好(语言置信度 1.0),但专有名词与数字是主要错源。 - 已校正的系统性误听:Gemini → "金蛋 / 静爱 / DVD / 金链 / 地平杆";Claude → "Cloud / Cless / Connect";Codex → "Protect / 扣带死 / collect子 / 发";WorkBuddy → "WalkBuddy / work by";QMT → "KMT";AKShare → "AKCR";DeepSeek → "DeepSeq";鼎盛方圆 → "顶层方圆 / 底层方圆";国金证券 → "国际证券";招商证券 → "交商证据";过拟合 → "几何";MACD 金叉 → "NV / FACD / 成金差";T+1 → "T加一";moneydata.net → "money date";新华传媒、湖北广电为疑似股票名,未进一步核实。
- 数字与口径存在口述与幻灯片不一致的地方,报告以幻灯片为准并注明差异:总览页为"¥3,000,000 → ¥3,032,242",讲者口述为"30 万变 303 万";回测区间讲者口述为"2026 年 1 月 1 号",按上下文("今天 24 号"、示例区间 2019-01—2026-10)应为 2025 年。
- 个别片段转写不清:01:09 章提到的"其他的一些标的"(疑似加密或其它币种)、"佣金低到百分之零点几"的精确费率、Q&A 中"8.67"这个不成句的数字、"数据是在小区上买的"一句,均无法确认,报告中已标注存疑,未做推测填充。
- 评论区样本只有 2 条,无法形成有代表性的观众观点分析;第四章的分析仅作页面证据使用,不能代表观众评价。
- 收益与胜率数据均为讲者自述,本报告未做任何独立核验,也不构成投资建议。幻灯片上的账户截图、策略指标均为演讲材料,未经第三方审计。
- 未做全片逐帧校验:关键帧基于转录中的视觉提示词、章节切换与场景检测(三种阈值扫描)联合筛选,共 22 张,覆盖各章节的可读幻灯片与演示状态;未选入的段落不代表没有画面信息,只代表该处画面未被判定为可佐证的视觉事件。
七、关键术语表
本表包含正文中以 <mark> 标出、并以脚注形式给出定义的规范化术语。术语优先采用视频中的讲法,括号内为等价说法。
八、思维导图
下图由报告章节与术语表生成,节点标签中的时间戳对应视频时间轴。
mindmap
  root((量化智能体:从规则到全自动回测))
    "00:00 开场与个人成绩单"
      "黄鸿波"
      "GDE"
      "鼎盛方圆"
      "复利"
    "01:09 什么是严肃量化"
      "量化"
      "回测"
      "过拟合"
      "高频交易"
    "03:30 连板选股与交易策略"
      "涨停板"
      "选股策略"
      "交易策略"
      "止盈止损"
      "仓位"
    "07:10 回测与未来函数"
      "未来函数"
      "复权"
      "分钟线"
      "T+1"
    "12:20 为什么引入 AI"
      "AI Agent"
      "Gemini"
      "DeepSeek"
    "16:15 多模型协同架构"
      "Claude"
      "产品 Runtime"
      "券商"
    "17:55 Gemini 六大特性与分工"
      "结构化输出"
      "Function Calling"
      "多模态理解"
      "Search Grounding"
      "上下文缓存"
    "22:15 AI 工作区与 Skills"
      "AI 工作区"
      "Skills"
      "Codex"
      "WorkBuddy"
      "量智 AI"
      "隔离沙箱"
    "34:50 平台实操演示"
      "舆情"
      "开放 API"
      "胜率"
      "最大回撤"
    "46:00 现场问答"
      "QMT"
      "AKShare"
      "宽基指数"
      "年化收益"
      "GDG Xi'an"
      "TensorFlow进阶指南"
无障碍大纲(无 Mermaid 渲染时的等价结构)
- 量化智能体:从规则到全自动回测
- 00:00 开场与个人成绩单:黄鸿波 / GDE / 鼎盛方圆 / 复利
- 01:09 什么是严肃量化:量化 / 回测 / 过拟合 / 高频交易
- 03:30 连板选股与交易策略:涨停板 / 选股策略 / 交易策略 / 止盈止损 / 仓位
- 07:10 回测与未来函数:未来函数 / 复权 / 分钟线 / T+1
- 12:20 为什么引入 AI:AI Agent / Gemini / DeepSeek
- 16:15 多模型协同架构:Claude / 产品 Runtime / 券商
- 17:55 Gemini 六大特性与分工:结构化输出 / Function Calling / 多模态理解 / Search Grounding / 上下文缓存
- 22:15 AI 工作区与 Skills:AI 工作区 / Skills / Codex / WorkBuddy / 量智 AI / 隔离沙箱
- 34:50 平台实操演示:舆情 / 开放 API / 胜率 / 最大回撤
- 46:00 现场问答:QMT / AKShare / 宽基指数 / 年化收益 / GDG Xi'an / TensorFlow进阶指南
九、关键帧索引
共 22 张,均为讲者明确指示观看的画面或演示状态切换处,取自 1280×720 视频原始分辨率。
| 时间 | 画面内容 | 触发依据 |
|---|---|---|
| 00:40 | 开场成绩单(193.45%) | "先看张图啊,因为有图才会有这个说服力" |
| 01:10 | 什么是量化:规则化表达对照 | 章节切换+"什么是量化"讲解 |
| 05:10 | 量化六宫格(规则化—持续迭代) | 讲者逐格朗读六项特性 |
| 08:12 | 量化研究是一条循环(Idea→Rules→Evidence) | "量化不是预测,是一个循环" |
| 11:22 | 趋势策略卡(买入/退出/时点/设置) | "我偏好趋势跟随"贯穿案例 |
| 13:22 | 为什么引入 AI(四步) | "用户不必先成为量化程序员" |
| 15:28 | 什么是 Gemini(三层能力) | 章节切换+"什么是 Gemini" |
| 18:28 | 六项 Gemini 特性表 | "主要是用它的六个特性" |
| 19:28 | Gemini 与产品 Runtime 分工 | "模型不充当行情数据库" |
| 20:32 | 量智 AI 产品介绍页 | 产品首页截图展示 |
| 22:36 | 两个入口+共同底座 | "左边对话,右边类似 Codex" |
| 24:38 | 追问成明确规则的三步 | "第一步:把偏好问成规则" |
| 25:38 | 产品总览(+1.07% / 3.47% / 48.83%) | 逐项朗读策略指标 |
| 27:42 | AI 工作区任务推进 | "像 Codex / WorkBuddy 一样推进任务" |
| 28:42 | 四类上下文结构图 | "一个工作区,组织四类上下文" |
| 29:48 | Search Grounding 代码示例 | "联网搜索找背景,行情工具给精确数字" |
| 30:48 | 回测执行链五步 | "先冻结数据,再运行代码" |
| 31:52 | 开放 API 三类能力 | "把数据和研究资产接到你的程序" |
| 35:02 | 重新登录后的产品首页 | 演示开始,讲者切换窗口 |
| 39:08 | 舆情分析 Skill 对话 | "帮我分析一下湖北广电的最新舆情" |
| 42:08 | 新建策略的追问澄清 | "筛选出最近三天都涨停的股票" |
| 55:22 | 测试广场策略列表 | "这里有个测试广场" |
十、本地产物
- 视频(720p,含音频):attachments/video.mp4
- 音频(AAC 流复制):attachments/audio.m4a
- 逐句时间轴(WebVTT):transcript.vtt
- 可读转写(按分钟分段):transcript.txt
- 结构化元数据(含硬件、ASR 选择、覆盖映射、术语表、关键帧记录):transcript.json
- 思维导图源文件:mindmap.mmd
- 页面上下文原始抓取(简介、评论、章节、统计):attachments/webpage_context.json
- 关键帧图片目录:attachments/shots/
GDG Xi'an:Google Developer Groups 西安社区,2012 年 8 月成立,主办本次分享(DEV FEST 2026 · Developer Session),官网 gdgxian.com。 ↩︎
黄鸿波:本次分享的讲者。AI 领域创业者、鼎盛方圆 CEO、Google 开发者专家(GDE),《TensorFlow 进阶指南》作者;历任金山西山居高级算法工程师、格力大数据中心 AI 专家。 ↩︎
鼎盛方圆:讲者创办的公司(深圳市鼎盛方圆科技)。视频幻灯片标注为"鼎盛方圆科技联合创始人",页面简介标注为 CEO;同场提到其获得 300 万美元天使轮融资。 ↩︎
复利:收益再投入后产生的滚动增长。开场成绩单标注"个人账户开户至今收益率 193.45%(复利)",与单利口径不可直接比较。 ↩︎
高频交易:以极高频率下单获利的交易方式。视频明确否认"量化=高频",指出低频、中频同样可以做量化,反对把量化等同于"机构收割"。 ↩︎
量化:把投资判断写成明确、可计算、可验证的规则,再用历史数据检验的一套研究方法。视频强调三要素:明确规则 + 数据计算 + 历史验证;它不等于预测,也不等于"AI 替你炒股"。 ↩︎
涨停板:A 股单个交易日价格涨幅达到上限(主板通常 10%)。视频的贯穿案例是"最近三天全部涨停"的连板选股,并强调必须区分"连续三个交易日涨停"与"三天内出现过涨停"。 ↩︎
选股策略:确定"买什么"的规则集合,例如"最近三天全部涨停+按成交量与换手率打分排序"。它与交易策略串联后构成完整流程。 ↩︎
交易策略:确定"什么时候买、什么时候卖"的规则集合,例如"先上涨、回调若干点后再度上攻时买入"。视频强调它必须与仓位、止盈止损、执行时点一起定义。 ↩︎
止盈止损:预先写死的退出规则。讲者举例:"涨 8% 不管后面涨跌都卖,跌 5% 不管能否涨回都卖"——用纪律替代情绪,是风控的核心。 ↩︎
仓位:单次或整体投入的资金比例。视频示例包括"单次只使用 20% 仓位",以及策略卡上的"仓位、止损、容量与权限"。 ↩︎
过拟合:策略在历史样本上表现优异、换到新样本或实盘就失效。视频中现场听众用它来质疑"不断调参让回测变好",讲者回答是"可以叫也可以不叫",并指出 A 股数据随市场漂移,与传统固定数据集的过拟合不完全相同。 ↩︎
T+1:A 股当日买入的股票次一交易日才能卖出。回测必须遵循该规则,否则结果虚高。 ↩︎
分钟线:以 1、5、30、60 分钟为周期聚合的 K 线。视频中的平台支持 A 股股票的日线与 1/5/30/60 分钟线,数据可回溯到 1990 年。 ↩︎
未来函数:回测时用到了当时还不可能知道的信息(例如用当日收盘价决定当日买入、用未来数据拟合过去)。表现为回测曲线异常漂亮、实盘严重亏损。视频给的防线是"收盘生成信号、下一根开盘模拟成交"。 ↩︎
复权:因分红、送股、拆股等原因对历史价格做连续性修正,分为前复权与后复权。不同平台、不同数据源的复权口径不一致,混用会让回测彻底失真——这是视频里反复强调的数据陷阱。 ↩︎
回测:把固定的规则作用在固定的历史数据上,重放并与历史行情对照,得到收益、回撤、稳定性与成本等指标。讲者的关键前提是"先冻结数据,再运行代码",否则结果不可信。 ↩︎
DeepSeek:国内大模型。视频中提到可以用于量化场景,但讲者不认同"量化出身做量化就一定好",只说它"相对来讲适合"。 ↩︎
Claude:Anthropic 的大模型,在本架构中专门承担"高质量代码生成"——把 Gemini 提炼出的策略转成策略代码。 ↩︎
券商:证券公司。视频反复强调数据应从券商采购以获得权威、统一的口径,并提到与三四十家券商的合作关系是其产品的资源壁垒。 ↩︎
Gemini:Google 的多模态大模型与开发平台,视频中作为"策略沟通与意图提炼"的主力模型,通过 Gen AI SDK / API 在服务端调用,并在 AI Studio 中试验提示。 ↩︎
结构化输出:让模型按既定 Schema(如 JSON)返回结果。视频用它把策略规则转成 JSON,驱动前端卡片与后端参数。 ↩︎
Function Calling:让模型输出结构化的工具调用请求,由外部代码执行后把结果返回模型。视频用它实现"研究意图 → 工具调用",涵盖行情、回测与文件操作。 ↩︎
多模态理解:模型同时理解文本、图像、图表、截图与文档的能力。视频用它帮助理解研究资料与图表。 ↩︎
Search Grounding(搜索增强):让模型在生成时调用搜索、并保留来源与时间标注。视频用它补充公开资料与研究背景,但明确"搜索负责找证据,不负责算数字"。 ↩︎
上下文缓存(Context Caching):把较长或重复的上下文缓存复用,降低推理成本与延迟。视频把它与 Thinking 一起列为"按任务配置推理、管理上下文与用量"的手段。 ↩︎
产品 Runtime:平台侧的执行层,负责校验参数与权限、取数、调用工具、执行回测并保存真实结果。视频反复强调它与模型的分工:"模型不充当行情数据库""模型不替代计算与授权"。 ↩︎
量智 AI:讲者团队的产品名(开放 API 站点 www.moneydata.net),把自然语言交易想法转成可验证的量化策略,产出策略文档、Python 代码与回测报告,并提供策略对话与 AI 工作区两个入口。 ↩︎
最大回撤:账户净值从历史高点到随后最低点的最大跌幅,衡量策略的极端风险。视频中的示例包括策略总览里的"平均回撤 3.47%"与单策略的"最大回撤 −7.20%"。 ↩︎
AI 工作区:视频中类似 Codex / WorkBuddy 的投研工作台,用四类上下文(任务会话、工作目录、Skills 规范、工具与事件)组织一个可持续工作的 Agent。 ↩︎
Skills(技能插件):把一类任务封装成可复用的执行单元,需声明输入、可用工具、可读资源、可执行动作与输出约定。视频中的例子包括舆情分析、回测比算、指数验证等。 ↩︎
Codex:OpenAI 的编程智能体产品。视频中作为"AI 工作区"的体验对标物:像 Codex 一样在对话中推进复杂任务并直接产出代码与文件。 ↩︎
开放 API:平台对外提供的程序接口。视频中为 REST API v1、API Key 鉴权,提供行情数据、个人策略与回测结果三类能力,供研究脚本与 Agent 调用。 ↩︎
年化收益:把一段时间的收益率折算为年化口径,便于跨周期比较。视频总览页的"高抛低吸策略平均年化 +1.07%"即此口径。 ↩︎
WorkBuddy:视频中被并列提及的 AI 助手类产品,作为"非专业量化者用 AI 工具写代码"以及 AI 工作区形态的参照。 ↩︎
AI Agent(智能体):能理解复杂意图、自主调用工具并执行多步骤任务的 AI 系统。视频把量化智能体定位为"把自然语言想法变成可验证策略并完成回测"的助手,而非交易决策者。 ↩︎
隔离沙箱:把回测代码放进受限环境执行,限制网络与文件权限,防止取错数据或越权操作。视频的回测执行链把它列为第 4 步"预检执行",并要求第 5 步通过审计才返回结果。 ↩︎
舆情:市场上的新闻、公告、社媒讨论等非结构化信息。视频中的平台接入实时新闻与资讯引擎,可回答"最近五分钟有没有大新闻",并把舆情与涉及股票关联。 ↩︎
QMT:券商提供的量化交易终端与接口权限,可用于程序化下单。视频称 A 股入金超过约十万元可申请开通,"除招商证券外基本都可以"。 ↩︎
胜率:盈利交易笔数占总交易笔数的比例。讲者自述其常用策略胜率在 50%—80%(更具体为 60%—80%),另有一个"高抛低吸"策略胜率约 58%。单看胜率无意义,需与盈亏比、回撤同看。 ↩︎
宽基指数:覆盖市场整体或大板块的指数,如沪深 300、中证 500 等。现场提问涉及宽基指数、ETF 与行业基金的策略支持,讲者答"后面会加指数策略",并称已有 1990 年至今的指数历史数据。 ↩︎
AKShare:开源金融数据接口库,数据多由公开渠道抓取。视频中把它作为"非券商权威数据源"的对照,提示口径与完整性风险。 ↩︎
GDE(Google Developer Expert):Google 官方认证的开发者专家计划,覆盖多个技术方向。讲者于 2020 年获得该称号,报告标题中的"GDE 专家"即由此而来。 ↩︎
《TensorFlow 进阶指南:基础、算法与应用》:讲者 2018 年出版的著作,幻灯片与页面简介中均有列出。 ↩︎